选型顺序是先定频段与接口形态,再挑软件形态,最后定对接协议。读写器硬件本身的差异有限,真正决定项目能不能上线的是软件这一层:它决定一台读写器的数据能不能进业务系统,也决定从十台扩到一百台时是改配置还是重写代码。曾参与的一个仓储盘点项目,硬件先采购、软件对接方案留到最后讨论,结果设备能稳定读到标签,业务系统却拿不到一条可用记录——每秒涌进来几百条原始读取,去重、过滤、业务映射都没有人负责。把这些教训拆开,就是下面要讲的三层内容。
先定频段与接口形态,再谈软件
频段决定识别距离与环境适应能力,接口形态决定软件接在哪一层,这两项定下来,软件选型才有边界。频段不是参数表上的一个数字,它直接决定现场要不要加屏蔽、标签往哪贴、以及软件要不要承担大规模去重的压力。
| 频段 | 典型频率 | 典型读取距离 | 介质适应 | 对软件的要求 |
|---|---|---|---|---|
| 低频 LF(ISO/IEC 18000-2) | 125–134 kHz | 10 cm 量级 | 金属、液体环境稳定 | 逐标签读取,按点对点处理 |
| 高频 HF(ISO 15693) | 13.56 MHz | 1 m 以内 | 对湿度不敏感,金属需离空 | 支持多标签,常用于门禁与借还 |
| 超高频 UHF(EPC Gen2 / ISO/IEC 18000-63) | 860–960 MHz | 数米量级 | 金属液体干扰明显 | 群读数据量大,必须做去重聚合 |
频率往上走,识别距离变远、群读能力变强,但抗金属与抗液体的表现会下降,这是物理规律决定的取舍,没有两头都占的方案。仓储出入库、月度盘点这类要求一次读几十上百个标签的场景,基本落在超高频;门禁考勤、图书借还、珠宝盘点这类对读取位置控制要求高的场景,高频更稳;需要在液体、金属工件附近保证可靠的,低频反而更合适。
接口形态决定软件接在哪一层
接口形态影响的是部署结构与开发方式,不是单纯插哪种线的问题。
| 接口形态 | 与主机的关系 | 软件接入方式 | 典型场景 |
|---|---|---|---|
| USB | 直连单台电脑 | 厂商动态库或串口指令 | 桌面写卡、标签初始化 |
| 串口 RS232 / RS485 | 点对点或总线 | 解析指令帧 | 工业设备、嵌入式柜体 |
| 网口(以太网) | 局域网独立设备 | LLRP、REST、MQTT | 固定式通道、多机部署 |
| 嵌入式模组 | 内置到终端 | 厂商 SDK 二次开发 | 手持机、自助终端 |
网口是分水岭:一台读写器接到局域网上之后,软件面对的就从一个”插在电脑上的外设”变成了一台网络设备,于是有了远程配置、固件升级、掉线重连这些额外工作。如果预计读写器会超过五台,接口形态优先考虑网口,避免后期再补串口服务器。
软件形态三类:现成软件、中间件平台与自研
小规模单点选现成软件,要对接多个业务系统选中间件平台,流程特殊且规模很大才考虑自研。三类形态的差别不在功能多少,而在你要承担多少开发量与长期维护责任。
| 形态 | 谁来用 | 开发量 | 合适规模 | 主要代价 |
|---|---|---|---|---|
| 现成软件 | 业务人员直接操作 | 接近零 | 单点、标准流程 | 业务流程要迁就软件设定 |
| 中间件平台 | 开发加运维 | 以配置为主 | 多读写器、多系统对接 | 授权费用与学习成本 |
| 自研 | 研发团队 | 全部自担 | 流程特殊、读写器数量大 | 设备兼容与长期维护 |
现成软件的吸引力是上线快,代价是流程被软件框住。不少团队一开始选现成软件,业务跑顺了才发现要接 WMS,这时候要么换软件,要么在现成软件外面再套一层同步程序,后者的维护成本往往超过当初省下的授权费。
中间件平台值得关注的一个特性是硬件无关性:同一套接口能对接不同品牌的读写器。这决定了三五年后换设备时,是只换硬件,还是连同业务代码一起改。评估时可以直接问一句:换一个品牌的读写器,业务侧的代码要不要动。
自研只在两种情况下合理——业务流程确实没有可复用的现成方案,或者读写器规模大到中间件的授权成本已经超过自研成本。自研最容易低估的是设备兼容工作,不同厂商对同一件事的参数命名、错误码、重连行为都不一样,这部分工作量常被忽略。
对接方式怎么挑:SDK、LLRP、REST 与 MQTT
验证阶段用厂商 SDK 或 REST 起步快,要多品牌混用或大规模部署就走 LLRP,标签事件量大再交给 MQTT。这四种方式不是互斥选项,一套系统里同时用两三种很常见。
| 对接方式 | 传输方式 | 跨品牌 | 开发量 | 更适合的阶段 |
|---|---|---|---|---|
| 厂商 SDK | USB、蓝牙或网络 | 否 | 低 | 单点验证、手持终端 |
| LLRP | TCP 长连接 | 是 | 高 | 固定式读写器多机部署 |
| REST | HTTP 请求 | 视实现而定 | 低 | 配置管理、轻量取数 |
| MQTT | 发布订阅 | 视实现而定 | 中 | 大批量标签事件上报 |
厂商 SDK 的优点是能拿到设备特有的能力,比如触发按键、天线功率档位、信号强度过滤,做手持终端这类交互密集型应用基本绕不开。代价是换品牌就要重写对接层。
LLRP 的价值在于可移植性,它是针对超高频读写器的通用控制协议,能在不同品牌的固定式读写器之间复用同一套代码,代价是消息结构偏重、开发周期更长。REST 和 MQTT 属于新一代读写器提供的接口形态,前者适合做配置和状态查询,后者适合把标签读取事件推给下游系统。
不管最后选哪种,做法上有一件事值得坚持:把读写器通信封在一层接口后面,业务代码只跟这层接口打交道。这样从 SDK 换到 LLRP、从单机换成多机时,改动的范围被限制在一个文件里,而不是散落在业务逻辑中。
选型维度与落地步骤
选型按五个维度打分,再按五步落地,每一步都有明确的通过标准。五个维度分别是频段与接口、软件形态、对接方式、数据链路和运维能力,其中前三个决定能不能用,后两个决定用起来累不累。
判断一个方案是否成熟,看它能不能把从设备到业务系统这条链路完整走通,而不是只看单点能不能读到标签。
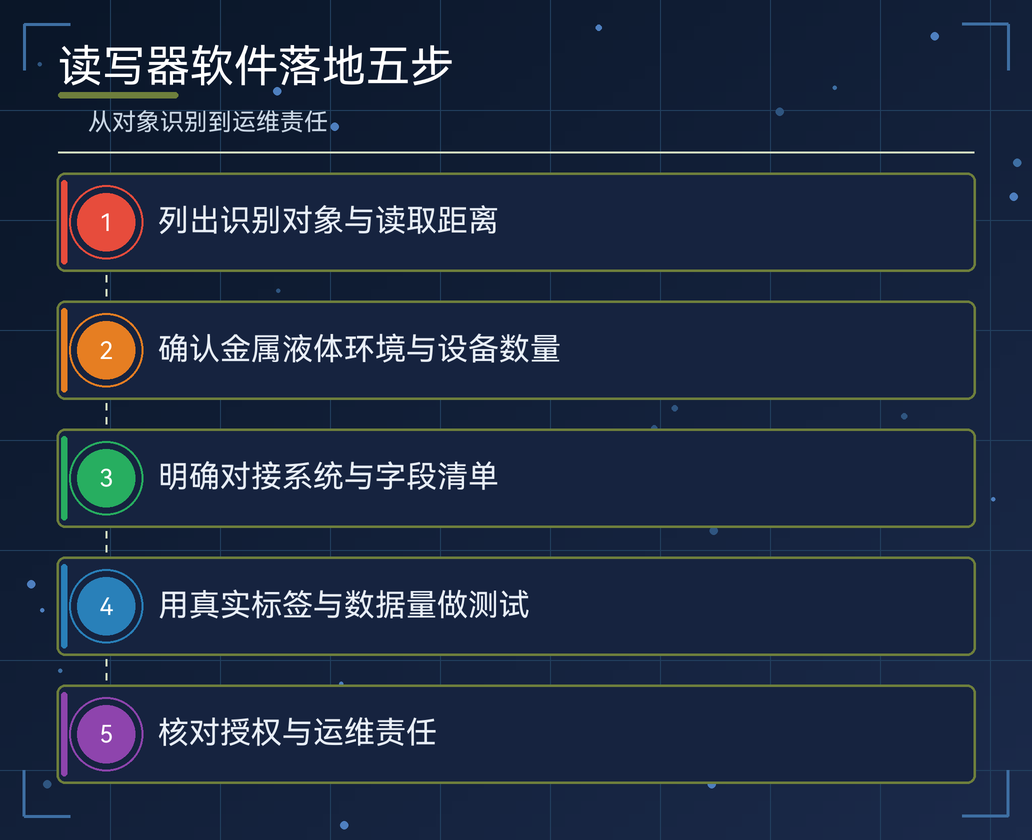
图上这条链路里的每一环都可以单独替换:换读写器品牌动的是接入层,换业务系统动的是事件输出层。按这个思路,落地步骤压缩成五步。
- 列出必须识别的对象和读取距离要求;
- 确认现场的金属液体环境和读写器数量;
- 明确要对接的业务系统与字段清单;
- 用真实标签和真实数据量做通道测试;
- 核对授权方式、扩容条款与运维责任。
这五步里最容易被跳过的是第四步。演示环境里标签干净、数量少、读取姿势标准,到了现场堆叠三层纸箱,读取率就会掉下来。把真实货物、真实码放方式搬进测试,比多比几份产品资料有用。到这里,从维度拆解到落地验证的链路就完整了。
数据处理:把原始读取变成业务事件
读写器交出的是原始标签读取,业务系统需要的是去重聚合后的业务事件,中间这层必须自己补上。一台超高频读写器在一次盘点上抛出几千条记录很正常,直接把每条读取写进数据库,表会迅速膨胀,业务侧也没法判断一件货物到底是”刚进来”还是”一直在旁边”。下面这段逻辑做的是最常见的两件事——在时间窗口内对同一标签去重,并把多台读写器的读取归并成一条到达事件。
from collections import defaultdict
import time

# 同一 EPC 在窗口内只保留一次读取,并记录最后出现时刻
WINDOW_MS = 1500

class ReadAggregator:
    def __init__(self, window_ms=WINDOW_MS):
        self.window_ms = window_ms
        self.last_seen = {}
        self.zones = defaultdict(set)

    def observe(self, epc, reader_id, zone, ts_ms=None):
        ts_ms = ts_ms or int(time.time() * 1000)
        prev = self.last_seen.get(epc)
        self.last_seen[epc] = ts_ms
        if prev is not None and ts_ms - prev < self.window_ms:
            return None          # 窗口内重复读取,直接丢弃
        self.zones[zone].add(epc)
        return {"epc": epc, "reader": reader_id, "zone": zone, "ts": ts_ms}

    def flush(self, zone, idle_ms=3000, now_ms=None):
        now_ms = now_ms or int(time.time() * 1000)
        events = []
        for epc in list(self.zones.get(zone, ())):
            if now_ms - self.last_seen.get(epc, 0) >= idle_ms:
                events.append({"epc": epc, "event": "arrived", "zone": zone})
                self.zones[zone].discard(epc)
        return events
这段逻辑里需要按现场反复调的参数只有窗口长度。通道窄、货物移动快,窗口取几百毫秒就够;货架盘点这类静态场景,窗口拉长到两秒可以明显减少同一条记录的抖动。窗口设太短,同一件物品会被记成两次到达,账面上多出来的库存比漏读更难排查。窗口设太长,快速连续通过的货物又会被合并成一次,出入库数量对不上。
如果数据还要跨系统甚至跨企业流转,事件格式值得按通用规范来设计,用标准的对象事件、聚合事件和交易事件描述”发生了什么、涉及哪些标签、在什么时间什么位置”,下游系统理解起来不用再做一次映射。
现场部署中反复出现的三个问题
金属遮挡、天线串读、数据量被低估,是三个几乎每个项目都会碰到的问题。它们大多不是软件写错了,而是物理环境和容量规划没提前算进去。
金属遮挡来自超高频的物理特性,贴着金属的标签读取距离会明显缩短。解决办法通常是换用抗金属标签、把标签垫高离开金属表面、或者调整天线朝向,这些都不需要改软件,但要在选型阶段就预留标签成本。
天线串读发生在相邻通道之间,一台读写器读到了本不该它负责的标签。算法上的处理是限定读取区域与时间窗,工程上的处理是降低天线功率、加屏蔽、用光电或 PLC 触发限定读取时段。串读不做处理,账面库存会长期偏高,而且很难靠对账发现。
数据量被低估则是最容易在后期爆发的隐患。标签数量一多,一天下来的原始记录量会远超预期。把读写器当成数据流而不是数据库插入源,在边缘侧完成过滤再说,是控制这部分成本更省力的做法。
常见问题(FAQ)
Q1:RFID 读写器软件一套大概多少钱?
差别主要在授权方式与实施服务,从免费的厂商配置工具到按读写器数量计费的中间件都有。
Q2:同一套软件能带不同品牌的读写器吗?
支持 LLRP 等通用协议的中间件通常可以,只封装厂商 SDK 的软件换品牌就需要改对接代码。
Q3:为什么软件读到的标签比现场实际数量多?
多天线串读与重复上报所致,加时间窗口去重并适当降低天线功率可以缓解。