
训练平台的差距不在显卡型号,而在框架兼容、算力组织与成本结构这三层。选型按三层判断:框架层看能否接住当前模型规模,算力层看自建还是租用,成本层看按量与包年怎么组合。三层里任何一层判断错位,都会表现为”卡不差、训练却慢且贵”。下面把每层的对比维度和判断边界逐条拆开,最后给出一条可执行的选型顺序。
去年帮一个做垂类模型的团队做平台评估时,对方已经在租来的八卡实例上跑了三个月,单步耗时比预期长,账单里存储和公网流量又占去两成。问题不在卡型,而在框架只用了数据并行,显存压力全部压在优化器状态上。换成分片方案之后,同一批卡能容纳的模型规模上去了,成本结构也跟着变了。这类调整不动硬件就能见效,前提是选型时把框架层和成本层放在一起看。
三维度对照:框架、算力与成本各管什么
三个维度各自回答一个不同的问题,混在一起看最容易得出错误结论。
| 维度 | 要回答的问题 | 判断依据 | 常见错配 |
|---|---|---|---|
| 框架层 | 现有训练框架能否支撑模型规模 | 参数量、并行策略、团队工程能力 | 小模型上重框架,复杂度先于收益到来 |
| 算力层 | 自建集群、租用实例还是全托管 | 利用率、任务周期、数据敏感度 | 低利用率选自建,闲置成本吃掉差价 |
| 成本层 | 按量、包年还是竞价 | 任务能否断点续跑、时长是否稳定 | 长任务不定包年,短任务买年付 |
三层的关系是自上而下的:框架决定需要什么样的互联与显存,显存与互联决定要不要多卡多机,多卡多机又决定算力组织方式。反过来判断——先看报价再挑框架——往往会买回一堆用不满的资源。
框架、算力与成本三层的对应关系,下面这张图给出了整体视图。
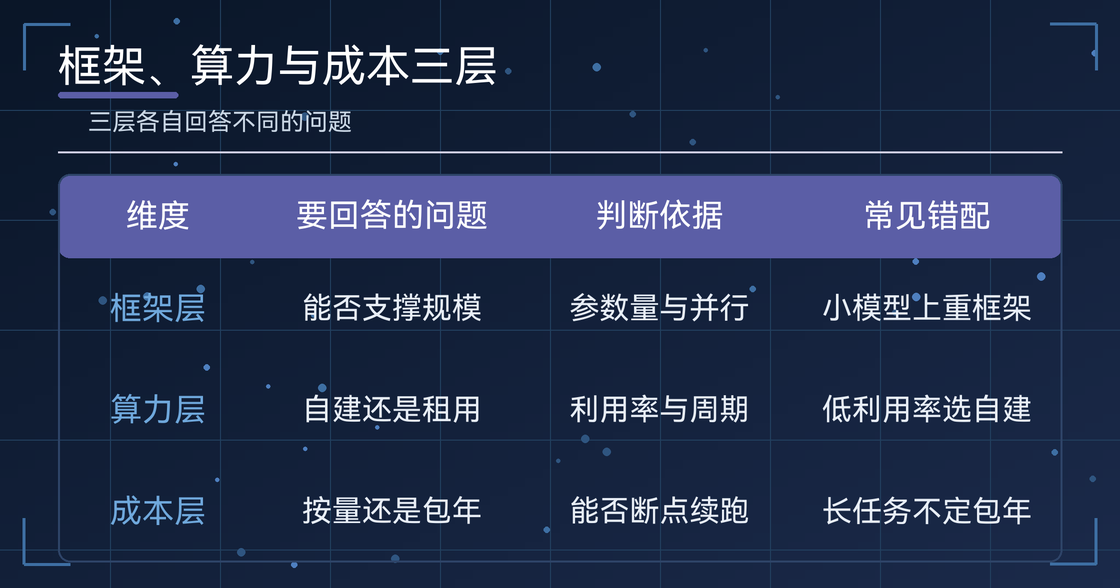
按图中的顺序自检一遍,就能发现多数团队真正的瓶颈停在哪一层,而不是笼统地归因于”算力不够”。
框架层怎么选:DDP、DeepSpeed 与 Megatron-LM 的边界
框架选择的依据是模型规模与团队工程能力,不是单次实验的吞吐跑分。三个常见选项的定位差异如下。
| 维度 | PyTorch DDP | DeepSpeed | Megatron-LM |
|---|---|---|---|
| 上手难度 | 较低 | 中等 | 较高 |
| 并行策略 | 以数据并行为主 | ZeRO 分阶段分片,支持 CPU 卸载 | 张量并行、流水线并行、序列并行 |
| 适合阶段 | 从单机过渡到分布式 | 显存吃紧、需要压低训练成本 | 百亿参数以上的大规模训练 |
| 对平台的要求 | 中等 | 较高,需要调度与镜像配套 | 高,依赖高速互联与整组资源调度 |
| 长期维护 | 相对可控 | 配置项多,调试链长 | 通常需要专人维护 |
框架能力越强,平台与团队要承担的复杂度也越高。判断显存是否够用可以先做一次粗算:一个 700 亿参数的模型在 FP16 精度下,参数本身就接近 140GB,再加上梯度与优化器状态,总量会达到数百 GB,单卡无论如何放不下。分片的意义就是把这三份数据切到多张卡上,每步只取回当前层需要的那一片。分布式训练的通信开销也会随卡数上升,节点间互联质量不够时,算力加得越多、等得越久。
对多数团队来说,先建立一条稳定的默认路径,比同时支持三套框架更划算。默认路径选 PyTorch DDP 或原生分片方案,把大规模训练作为特例单独评估,运维和支持成本都会低一截。
算力层怎么选:自建集群、租用实例与全托管
三条算力路径的分界点是长期利用率与任务周期,不是采购单价。
| 对比项 | 自建集群 | 租用 GPU 实例 | 全托管训练平台 |
|---|---|---|---|
| 初始投入 | 硬件一次性支出,规模级投入 | 接近零 | 接近零 |
| 扩容速度 | 以周计,需采购与上架 | 分钟级 | 分钟级 |
| 单位算力成本 | 长期满载时相对较低 | 按量时偏高,包年有折扣 | 介于两者之间 |
| 运维负担 | 需要专职运维与机房配套 | 训练环境自己维护 | 平台统一维护 |
| 适配场景 | 长期稳定负载、数据需物理自控 | 负载波动、实验与调参 | 工程人手有限、以算法为主 |
自建是否划算,取决于长期利用率能否稳定维持在高位。硬件是刚性支出,任务空档期机器照样折旧,利用率一旦掉下来,单位算力成本会迅速反超租用。租用路线的问题在另一头:弹性是买到了,但公网出站流量、云盘、快照、高速网络往往单独计费,账单容易超预算。评估时把这三类附加项单列出来,比只比每小时单价更接近真实成本。
常见的折中是”主力加弹性”:把稳定负载放在包月资源上拿折扣,把峰值任务放到按量资源上。数据量大的团队还要额外考虑搬运成本,重复下载 TB 级数据集产生的流量费,往往比多租几张卡更贵。
成本层怎么选:按量、包年与竞价的组合
三种计费方式对应不同任务节奏,多数团队实际用的是组合而不是单选。
| 计费方式 | 单价水平 | 灵活性 | 主要风险 | 适合任务 |
|---|---|---|---|---|
| 按量计费 | 较高 | 随时开关,闲置不计费 | 忘记释放实例会持续计费 | 调参、实验、短周期任务 |
| 包年包月 | 较低,折扣常见在三到四成 | 期间不可退 | 任务中断则资源闲置 | 稳定长周期的训练 |
| 竞价实例 | 低于按量 | 随时可能被回收 | 任务被强制中断 | 可断点续跑的离线训练 |
| Serverless 算力 | 按实际运行时长计 | 不用管理实例 | 有冷启动与单次时长限制 | 批量处理、低频任务 |
竞价实例能不能用,判断标准只有一条:任务是否做了断点续跑。训练脚本按固定步数保存检查点是通行做法,被回收后从最近一次检查点继续,损失可控。反过来,没有检查点机制的交互式训练不适合放到竞价资源上。
监控同样是成本手段。团队在评估阶段应当把 GPU 利用率、单次任务成本、闲置容量三项做成看板,闲置容量是最常见的浪费来源,发现后通常靠自动缩容就能解决。
训练脚本的断点续跑怎么写
把检查点读写封装成两个函数,任务被中断后就能从最近状态继续,这是使用弹性算力的前提。
import os
import torch

def save_ckpt(path, model, optimizer, step):
    os.makedirs(path, exist_ok=True)
    torch.save({
        "step": step,
        "model": model.state_dict(),
        "optim": optimizer.state_dict(),
    }, os.path.join(path, f"ckpt-{step:06d}.pt"))

def load_latest(path, model, optimizer):
    if not os.path.isdir(path):
        return 0
    files = sorted(f for f in os.listdir(path) if f.endswith(".pt"))
    if not files:
        return 0
    state = torch.load(os.path.join(path, files[-1]), map_location="cpu")
    model.load_state_dict(state["model"])
    optimizer.load_state_dict(state["optim"])
    return state["step"]
落地时注意两点:保存间隔要按可承受的重复计算量来定,太密会拖慢训练,太稀则回滚代价大;检查点存放位置最好与计算实例解耦,否则实例被回收时文件一起丢了。写完这两个函数,弹性算力才真正可用。
选型顺序:先压测,再标准化
把选型流程压成三步,每一步都有明确的产出:
- 用按量计费跑一周基线任务,记录显存占用与单步耗时;
- 按实测峰值确定卡型与卡数,只留少量冗余,不做超量采购;
- 把训练环境容器化并固化默认框架路径,保证资源能在平台间搬迁。
顺序不能颠倒。先压测再定配置,才不会为用不到的算力买单;先固化路径再做平台化,才能避免每个团队各选一套框架、运维成本成倍上升。
常见问题(FAQ)
Q1:训练平台能不能直接拿开源框架跑起来?
能。单卡或小规模分布式用开源框架即可起步,模型规模上去后再评估分片方案。
Q2:为什么包年包月不一定比按量便宜?
包年买的是时长确定性。任务中断或利用率偏低时,闲置资源会把折扣吃掉。
Q3:竞价实例适合哪种训练任务?
适合已做断点续跑的离线训练与批量任务,不适合交互式长任务。

