
主轴抱死之前,那台风机的振动量已经连着两周在刷屏,班组按经验把它归进了噪音。AI 人工智能诊断系统能不能用起来,取决于四条链路是否首尾相接:设备信号接入、特征与基线建模、阈值与告警分级、工单闭环。缺任何一段,系统都会退化成一块没人看的看板——传感器在传数,曲线在动,现场却不会因此少停一次机。给一家金属加工厂搭设备诊断时,真正的转折点不在模型精度,而在振动量在换产品规格后成片报警的处理方式。下文按这四个环节逐段拆开,每一步给出可以直接照做的动作。
第一步:把异构设备信号接进同一套点位模型
设备诊断系统的起点是把不同品牌、不同年代的信号统一到一套点位模型,而不是先挑算法。现场通常三种协议混存:老 PLC 走 Modbus,SCADA 侧走 OPC UA,新装的无线传感器走 MQTT。接入层要做的是协议解析、时间戳对齐与本地缓存,让上层拿到的每条记录都带上设备编号、测点号与采集时刻。
这一步踩坑最多的是时间戳。网关各写各的本地时间,一旦与服务器时钟差出几分钟,后续做多测点关联时就会把”温度先升、振动后起”的因果关系算反。把网关统一走 NTP 对时、并在接入层强制补上采集端时间,比事后在分析层猜时间轴省力得多。
先明确要采哪些量,再选传感器,能省掉一批无效测点。多数旋转设备的早期劣化会先在振动与温度上露头,电流和声学则用来交叉验证。
| 信号类型 | 采集频率参考 | 主要用来判断 | 常见坑 |
|---|---|---|---|
| 振动速度或加速度 | 千赫兹级采样,特征按秒聚合 | 轴承磨损、不平衡、松动 | 采样率不够,高频故障特征被截掉 |
| 轴承与壳体温度 | 秒级到分钟级 | 润滑失效、过载 | 测点贴在散热面上,响应滞后 |
| 电机电流 | 秒级 | 机械卡死、缺相 | 变频工况下需按频率归一 |
| 压力或差压 | 秒级 | 滤网堵塞、泵磨损、阀门内漏 | 未做零点校准,基线整体漂移 |
协议侧的重点是选一套能长期维护的接法,而不是一次接得最快。
| 协议 | 常见对象 | 接入要点 | 常见坑 |
|---|---|---|---|
| Modbus | 老 PLC、仪表 | 寄存器地址表要落到文档里 | 地址表丢失,换人接手要重新试点 |
| OPC UA | SCADA、DCS | 按节点订阅,避免全量轮询 | 订阅过宽把网关 CPU 打满 |
| MQTT | 无线传感器、网关 | 按测点分主题,带 QoS 与保留消息 | 主题命名随意,后期无法批量治理 |
| 厂商私有接口 | 专用控制器 | 尽量在网关侧转换为标准模型 | 直接让上层解析私有格式,绑死一家 |
三类协议归一之后,上层拿到的是一张扁平化的测点表:设备编号、测点号、物理量、单位、时间戳、数值。有了这张表,后面的特征计算和告警规则才不用为每个品牌写一套分支。
第二步:把原始波形压成特征,别把全量信号往上送
高频采样数据不适合全量回传,特征提取同时省带宽和省算力。千赫兹级采样的振动通道一天产生的原始点数远超常规带宽预算,而诊断真正需要的往往只是频域峰值、均方根、峭度、冲击指标这几个量。在边缘侧算完特征,只把特征向量与判定为异常的原始片段回传,是这类系统通行的做法。
特征选得对不对,直接决定模型能识别什么故障。轴承内圈剥落会在特定倍频处抬高幅值,不平衡表现为转频分量突出,松动则常出现明显的倍频与边带。把这几类频域指标和时域统计量凑成一组固定维度的向量,比让模型直接吃原始波形稳定得多,也便于现场工程师看懂告警依据。
工程上有个容易被忽略的取舍:特征窗口太长会抹掉冲击信号,太短则统计量抖动大。多数场景按秒级滑窗、并在窗口内保留峰值统计,能兼顾两侧。窗口长度一旦定下就写进配置,别让不同批次的设备各用一套。
第三步:用动态基线取代固定阈值
固定阈值在工况一变就失效,基线学习是控住误报的关键手段。同一台风机在不同转速与负载下的振动本底差异很大,拿一个绝对数值当红线,换产品规格那天系统就开始刷屏。更稳的做法是先用一段正常运行数据建立该测点的正常态分布,再对实时序列算偏离度,只有偏离足够显著才进入告警判定。
基线的建立周期取决于工况覆盖度。只看一种产品规格的数据,学到的”正常”其实只是一种工况。可行的做法是按工况分组建基线,用转速、负载、启停状态作为分组键,每组各自维护均值与标准差。下面这段逻辑给出最小实现骨架,重点是先学基线、再打分,而不是把阈值写死在代码里。
# 测点级基线偏离度评分:先学正常态,再对实时值打分
import statistics

def build_baseline(history):
    mu = statistics.mean(history)
    sigma = statistics.pstdev(history) or 1e-6
    return mu, sigma

def deviation_score(value, mu, sigma, k=3):
    z = abs(value - mu) / sigma
    return z, z > k          # 偏离超阈值才进入告警判定

load_normal_window = load_history(asset_id="fan-01", mode="load-70")
mu, sigma = build_baseline(load_normal_window)
score, suspect = deviation_score(real_time_value, mu, sigma)
这段代码要落地还要补两件事:一是按工况分组取窗口,二是把 k 值做成按测点可调。固定阈值并非完全不用,安全相关的限值仍然要保留硬阈值兜底,基线负责的只是把”正常波动”从告警里剔除出去。
第四步:给告警分级,再把它转成工单
告警分级与工单闭环决定这套系统有没有人真的在用。工程上多数按三级分:提示级只进趋势看板,预警级进本周检修计划,告警级自动生成工单并指定责任人。分级的依据不只是偏离幅度,劣化速率同样关键——偏离不大但两天内持续走高,比一次跳变更值得立刻安排停机窗口。
从采集到处置的完整链路可以这样理解。
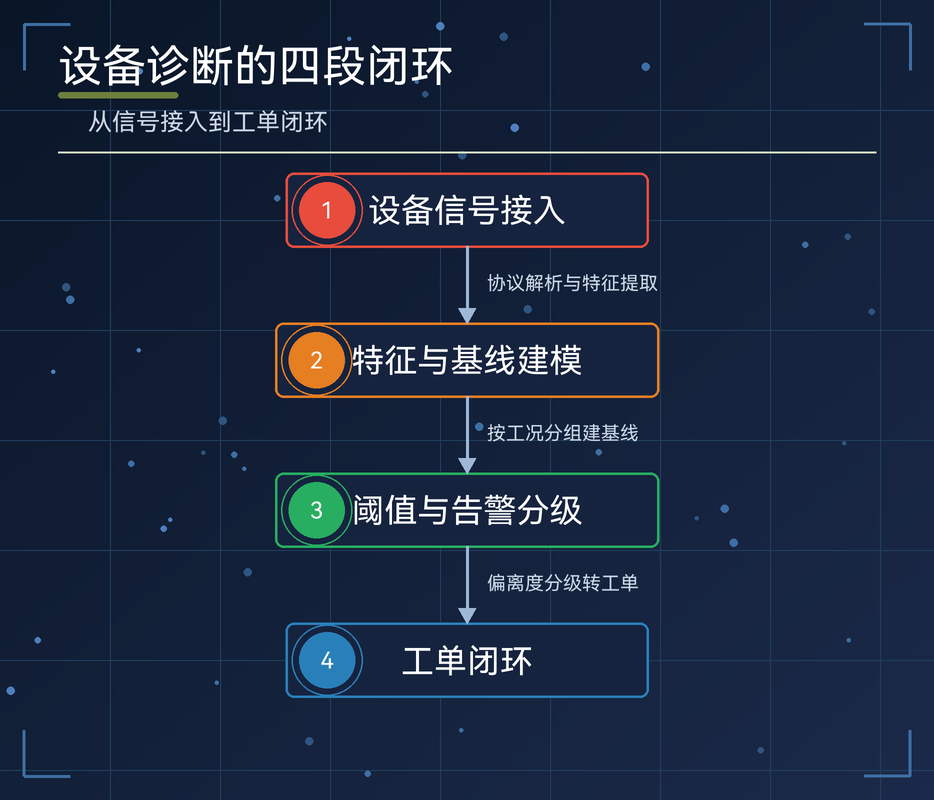
把告警转成工单,关键是把上下文一并带过去。工单里至少要写清设备编号与位置、触发的测点与时间、偏离基线多少、近期的劣化趋势以及建议的检查动作。维修人员在现场才能凭一条工单判断该先看哪里,而不是收到一句”振动超标”。告警分级到工单的映射建议在系统里固化下来:
- 按偏离幅度与劣化速率算出告警等级,不做人工二次判断;
- 告警级自动开工单并推送责任人,预警级进本周计划池;
- 工单里附上测点基线、当前值与近 24 小时趋势片段;
- 关单时强制填写实际故障与误报标记。
落地顺序与验收看什么
首批试点不要铺满全厂,先拿十几台关键设备跑通全链路,再谈规模。设备选型上优先挑有历史故障记录、且停机代价明确的机组,这类设备能在较短时间内给出可判断的反馈。铺得太散的结果往往是数据接了一堆,却没有一个闭环能验证。
- 梳理设备清单,按停机代价排序,圈出首批试点范围;
- 接入测点并核对时间戳,确认连续七天无丢数;
- 采集正常态数据,按工况分组建立基线;
- 用回放历史数据验证告警分级,先跑影子模式不推人;
- 接通工单系统,正式推送并跟踪关单率与误报率。
验收指标建议盯四个:告警准确率、平均响应时长、工单关单率、以及关单时填写的实际故障是否与预测一致。误报率在高位徘徊时,先查基线与工况分组,不要急着换模型——多数误报出在工况没分够细上,而不是算法不够复杂。
常见问题(FAQ)
Q1:振动测点多久采一次才够用?
按故障类型定:轴承类故障需千赫兹级采样后再降维,温度类秒级即可。
Q2:固定阈值为什么总是误报?
它假设工况恒定。转速与负载一变,正常波动就跨过红线,需改用基线偏离度。
Q3:能不能先只推给一个班组试用?
可以。先跑影子模式只记录不推送,比对两周后再放开,接受度会高很多。

