在前端开发中,统计字符串长度似乎是一个再基础不过的操作,通常一行 str.length 就能搞定。然而,随着移动互联网的普及和社交属性的增强,用户输入的内容早已不再局限于 ASCII 字符或常见的汉字。当你的表单验证、字数统计或数据库存储逻辑遇到“😀”、“👨👩👧👦”或者带肤色修饰的“👍🏻”时,原生的 .length 属性往往会给出一个令人大跌眼镜的错误数值。这并非 JavaScript 引擎的缺陷,而是源于其底层字符编码机制与现代 Unicode 标准之间的错位。要真正解决这一问题,开发者必须深入理解 UTF-16 编码原理、代理对(Surrogate Pairs)以及字素簇(Grapheme Cluster)的概念,并选择恰当的切割策略。
一、原生 length 属性失效的底层逻辑
JavaScript 引擎在内部处理字符串时,采用的是 UTF-16 编码格式。在 UTF-16 中,字符被分为两个平面:基本多文种平面(BMP)和辅助多文种平面(SMP)。BMP 中的字符(如英文字母、数字、常用汉字)码点范围在 U+0000 到 U+FFFF 之间,它们在内存中占用 16 位(2 字节),即一个代码单元(Code Unit)。对于这类字符,.length 返回的值确实等于字符个数。
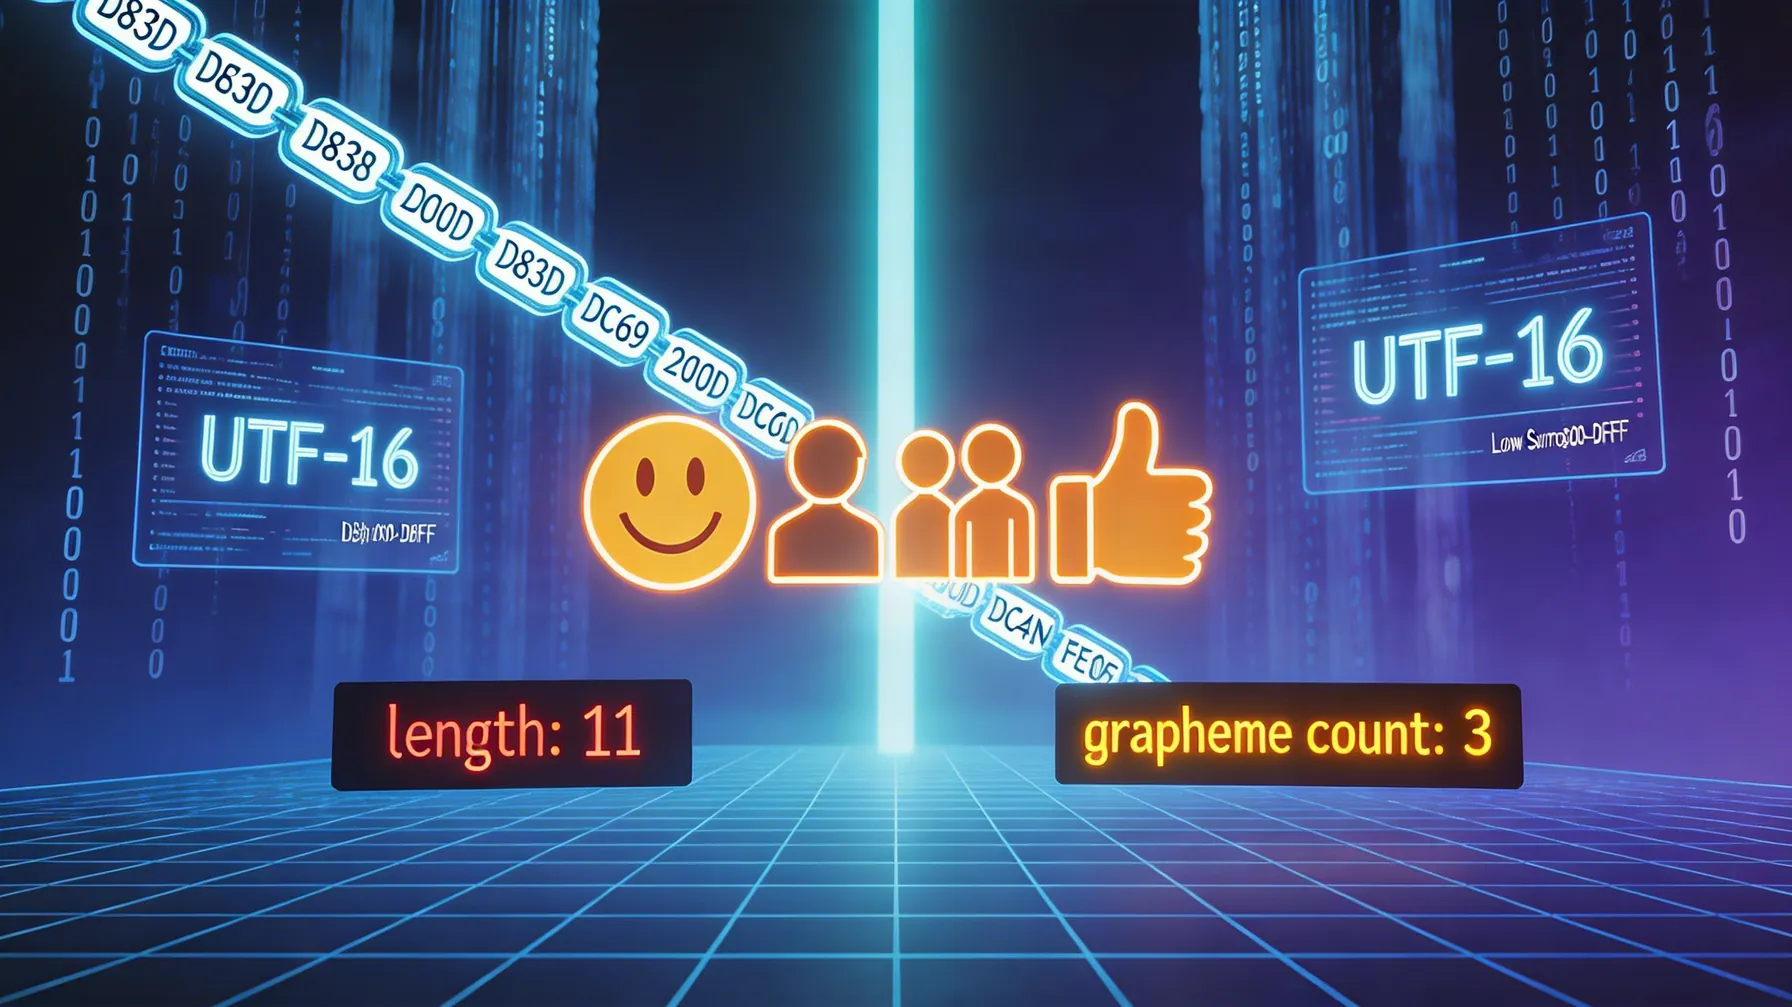
问题出在辅助平面的字符上。绝大多数 Emoji 表情、生僻汉字以及一些特殊的数学符号,其 Unicode 码点都超过了 U+FFFF。为了在 16 位的系统中表示这些字符,UTF-16 采用了“代理对”机制,即用两个 16 位的代码单元来共同表示一个字符。这两个单元分别被称为高代理项(High Surrogate)和低代理项(Low Surrogate)。
当你执行 "😀".length 时,JavaScript 引擎实际上是在统计代码单元的数量,而不是用户感知的“字符”数量。字符 “😀” 的码点是 U+1F600,在 UTF-16 中被编码为 uD83DuDE00。这里包含了两个代码单元,因此 .length 返回 2。如果是一个更复杂的组合表情,比如“👨👩👧👦”(一家四口),它是由多个基础 Emoji 通过零宽连接符(ZWJ, Zero Width Joiner)拼接而成的。在底层,这个看似单一的图形可能由 7 个甚至更多的代码单元组成。若直接用 .length 校验,用户输入的一个表情可能会被判定为输入了 7 个字符,导致前端提示“字数超限”,而用户却一脸茫然,这种体验是灾难性的。
二、基于 Code Point 的进阶统计方案
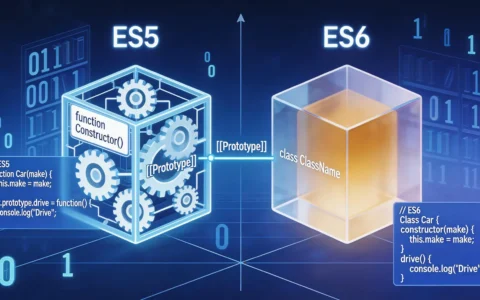
为了解决代理对导致的计数错误,ES6(ECMAScript 2015)引入了一系列针对 Unicode 的新特性,其中最直接有效的方法是利用扩展运算符(Spread Operator)或 Array.from() 方法。这两种方式在遍历字符串时,会自动识别代理对,将完整的 Unicode 码点作为一个整体进行处理,从而得到正确的“码点数量”。
使用扩展运算符 [...str] 是最简洁的写法。当你对一个包含 Emoji 的字符串进行展开操作时,JavaScript 引擎会调用字符串迭代器,该迭代器能够正确解析 UTF-16 序列,将成对的代理项合并为一个元素。例如,对于字符串 const s = "Hi😀",[...s] 会生成数组 ['H', 'i', '😀'],此时数组长度为 3,完全符合预期。同样的逻辑也适用于 Array.from(str),它在内部处理逻辑上与扩展运算符类似,都能准确地将双字节的代理对视为单个字符。
这种方法在处理绝大多数独立的 Emoji 表情时表现完美,无论是笑脸、火箭还是各国国旗,都能被正确计为 1 个长度。它的兼容性也相当不错,覆盖了所有现代浏览器和 Node.js 环境。对于大多数业务场景,如简单的字数统计、数据库字段长度预校验,这种基于码点(Code Point)的统计方式已经足够应付。它解决了“一个表情算两个字符”的核心痛点,且代码侵入性极低,无需引入额外的重型库。
不过,基于码点的统计依然存在局限性。它虽然能识别代理对,但无法处理“字素簇”(Grapheme Cluster)。在某些复杂的语境下,用户眼中的“一个字符”在 Unicode 标准中实际上是由多个码点组合而成的。例如,带有肤色修饰的大拇指“👍🏻”,它由“大拇指”码点和“浅色皮肤”修饰符码点组成;再比如带有性别标识的家庭组合“👨👩👧”,中间穿插了零宽连接符。在基于码点的统计中,这些组合体依然会被拆解为 2 个或多个独立的元素,导致计数结果大于用户视觉感知的数量。如果你的应用场景对字数限制极其严格(如微博类平台的 140 字限制,或某些严格的表单输入),仅仅依靠扩展运算符可能还不够精准。
三、利用 Intl.Segmenter 实现字素簇级精确切割
为了达到像素级的精确度,即完全按照人类视觉感知的“字符”来统计长度,我们需要引入更高级的工具——Intl.Segmenter API。这是 ES2022 引入的一个国际化对象,专门用于处理语言敏感的文本分段。它不仅能处理单词分割,更能依据 Unicode 标准算法,准确识别并分割“字素簇”。
Intl.Segmenter 的核心优势在于它理解字符之间的语义关联。当我们将 granularity 参数设置为 'grapheme' 时,它会分析字符串中的每一个码点及其上下文关系。如果遇到零宽连接符(ZWJ)或组合变音符号,它会将这些分散的码点“粘合”在一起,视为一个不可分割的整体单元。这意味着,无论是一个简单的笑脸,还是一个由五六个码点组成的复杂家庭表情,甚至是带有多个修饰符的自定义表情,Intl.Segmenter 都能将其识别为长度为 1 的单一实体。
具体实现上,首先实例化一个 Intl.Segmenter 对象,指定语言环境(如 ‘zh’ 或 ‘en’)和粒度为 ‘grapheme’。然后调用其 segment 方法传入目标字符串,该方法返回一个可迭代对象。最后,通过 Array.from() 将其转换为数组并获取长度。这种方式的计算结果最贴近用户的真实感知,彻底消除了因编码细节导致的计数偏差。
当然,采用 Intl.Segmenter 也需要考虑兼容性问题。虽然 Chrome 87+、Safari 13.1+、Firefox 87+ 以及较新版本的 Node.js 都已经原生支持,但在一些老旧的移动端浏览器或企业内部系统中,该 API 可能尚未覆盖。在这种环境下,开发者通常需要降级处理,回退到基于扩展运算符的方案,或者引入如 grapheme-splitter 这样的第三方库来模拟其行为。对于追求极致用户体验且主要面向现代用户群体的应用,Intl.Segmenter 无疑是当前的最优解。
四、不同场景下的技术选型与性能权衡
在实际工程落地时,盲目追求最精准的方案未必是最佳选择,需要结合具体场景进行权衡。如果仅仅是为了在输入框下方显示“已输入 X/100 字”这样的提示,且后端数据库字段是以字节或码点为单位存储的,那么使用 [...str].length 这种轻量级方案完全足够。它的执行效率极高,几乎零开销,且代码可读性强,维护成本低。
反之,如果业务涉及严格的字符数限制,例如短信发送(按条计费)、推文发布(严格按视觉字符截断)或某些特定国家的合规性要求,那么必须采用 Intl.Segmenter。因为在这些场景中,将一个组合表情误判为多个字符可能导致用户内容被意外截断,或者产生额外的费用纠纷。此时,准确性优于微小的性能损耗。
此外,还需要注意截断(Truncate)逻辑与长度统计的一致性。很多时候,我们不仅需要知道长度,还需要在超长时截取字符串。如果使用扩展运算符统计长度,却用原生的 substring 进行截取,极有可能在代理对的中间位置切断字符串,导致渲染出乱码或半个表情。因此,统计与截取必须使用同一套逻辑:若用扩展运算符统计,则应先展开为数组,切片后再合并;若用 Intl.Segmenter,则应基于其分段结果进行截取。保持逻辑闭环,才能确保数据在不同环节流转时的一致性。
对于淘宝客或电商推广场景,商品标题往往包含大量特殊符号和 Emoji 以吸引点击。在抓取或生成这类标题时,准确的长度判断能帮助优化展示效果,避免因标题过长在移动端被折叠而丢失关键信息。通过上述技术方案,可以智能地计算出视觉上的有效字符数,从而动态调整标题策略,提升点击转化率,同时避免触碰平台的字数违规红线。
掌握字符串长度的正确计算方式,不仅是解决一个技术 Bug,更是对国际化标准和用户体验的尊重。从理解 UTF-16 的局限,到运用 ES6 新特性,再到拥抱最新的 Intl API,这一过程体现了前端技术不断向精细化、人性化发展的趋势。