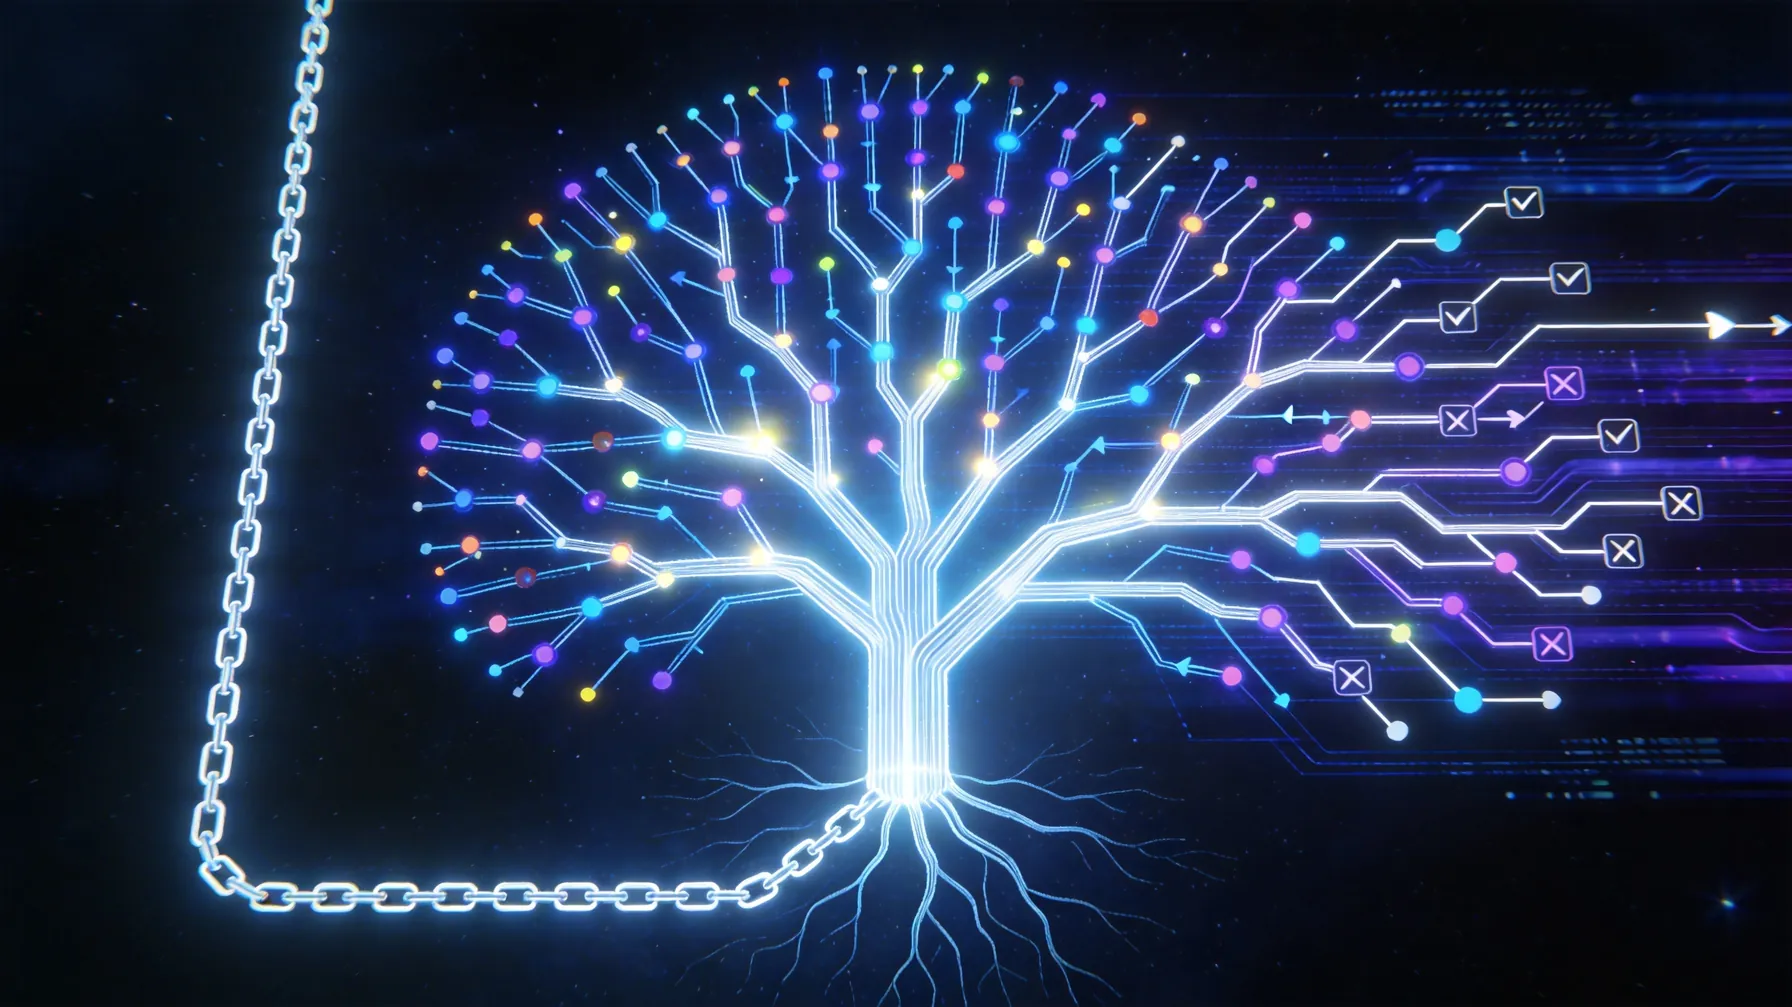
思维树(Tree of Thoughts, ToT)是一种超越传统链式推理(Chain-of-Thought, CoT)的高级提示工程方法,它允许大语言模型(LLM)在解决问题时并行探索多个推理路径,并通过“评估-选择-回溯”机制动态优化决策。ToT 模拟人类在复杂问题中“多想几种可能”的认知过程,显著提升了模型在规划、搜索、创造性任务中的表现。
一、核心思想对比:CoT vs ToT
| 特性 | Chain-of-Thought (CoT) | Tree of Thoughts (ToT) |
|---|---|---|
| 推理结构 | 线性、单路径 | 树状、多分支 |
| 探索方式 | 一步接一步,不可逆 | 并行生成多个“中间想法”(thoughts) |
| 决策机制 | 无显式评估,直接推进 | 对每个节点进行价值评估,选择最优分支 |
| 容错能力 | 一旦早期出错,后续全错 | 可回溯、剪枝、重试其他路径 |
| 适用任务 | 简单推理、数学计算 | 复杂规划、创意生成、博弈、代码设计 |
✅ 关键区别:
CoT 是“一条路走到黑”,ToT 是“走几步,看看哪条路更靠谱,再决定”。
二、ToT 的工作原理(四步循环)
ToT 将问题求解建模为在思维树上的搜索过程:
步骤 1:Thought Generation(生成候选中间状态)
- 在当前节点,生成 k 个可能的下一步推理(如不同解题策略、大纲选项)。
- 示例(写故事):
当前:主角发现神秘信件
候选 thoughts:
A. 他决定报警
B. 他独自追踪线索
C. 他找朋友商量
步骤 2:State Evaluation(评估每个 thought 的前景)
- 让 LLM 扮演“评判者”,对每个候选打分或排序:
“从故事张力、逻辑合理性和创新性角度,评估 A/B/C 三个选项。”
步骤 3:Search Algorithm(选择扩展策略)
- 基于评估结果,决定如何继续:
- 贪心搜索:只保留最高分的 1~2 个分支;
- 广度优先:保留所有分支,继续扩展;
- 束搜索(Beam Search):保留 top-k 分支。
步骤 4:Backtracking(必要时回溯)
- 若某分支陷入死胡同(如无法继续推理),退回上一节点,尝试其他路径。
🔁 整个过程可迭代多层,形成深度搜索树。
三、ToT 相比 CoT 的核心优势
1. 更强的探索能力
- CoT 容易陷入局部最优(如一开始就选错解题方向);
- ToT 通过多路径探索,大幅提升找到全局最优解的概率。
📊 实验数据(原始 ToT 论文):
- 24 Game(数字游戏):CoT 成功率 4%,ToT 达 74%
- 创意写作:ToT 生成的故事在连贯性与新颖性上显著优于 CoT
2. 支持中间决策与修正
- CoT 无法“后悔”,ToT 允许在关键节点重新选择。
- 适用于需要阶段性判断的任务(如项目规划、诊断流程)。
3. 更适合非确定性问题
- 对于没有唯一正确答案的任务(如产品设计、营销策略),ToT 能生成多样化的高质量方案供人选择。
4. 可与外部工具结合
- 每个 thought 可触发工具调用(如搜索、代码执行),评估结果基于真实反馈,而非纯语言推测。
四、ToT 的典型应用场景
| 场景 | ToT 如何发挥作用 |
|---|---|
| 复杂问题求解 | 如数学证明、算法设计,探索多种解法 |
| 战略规划 | 生成多个业务发展路径,评估风险与收益 |
| 创意内容生成 | 为故事/广告/产品命名提供多个方向,择优深化 |
| 代码生成 | 尝试不同架构(OOP vs 函数式),选择最简洁实现 |
| 多跳问答 | 对每个子问题生成多个假设,验证后整合 |
五、实战示例:用 ToT 解决“24 点游戏”
问题:用 3, 3, 8, 8 通过加减乘除得到 24。
CoT 方式(易失败):
“先算 8 ÷ (3 – 8 ÷ 3) = …… 等等,这不对。” → 卡住
ToT 方式:
- 生成初始 thoughts(可能的第一步操作):
- A: 8 ÷ (3 – 8/3)
- B: (8 × 3) + (8 – 3)
- C: (8 + 8) × (3 ÷ 3)
- 评估每个 thought:
- A: “表达式合法,可能接近答案”
- B: “8×3=24,但+5=29,超了”
- C: “16×1=16,太小”
- 选择 A 继续扩展:
- 计算 8 ÷ (3 – 8/3) = 8 ÷ (1/3) = 24 → 成功!
✅ ToT 通过评估快速聚焦到正确路径。
六、实现挑战与应对
| 挑战 | 解决方案 |
|---|---|
| Token 消耗大 | 限制树深度(如 ≤3 层)、每层候选数(k=3~5) |
| 评估不准确 | 使用更强模型做评判,或结合程序验证(如数学计算) |
| 实现复杂 | 利用 LangChain 的 PlanAndExecute 或自定义 ToT 代理 |
| 延迟高 | 对高价值任务启用,普通任务仍用 CoT |
💡 简化版 ToT(实用推荐):
“请提出 3 种不同的解决方案,分别评估其优缺点,然后推荐最佳方案。”
→ 无需完整树结构,已能获得 ToT 的核心收益。
七、未来演进:ToT + Agent + 工具
新一代 AI 系统正将 ToT 与智能体(Agent)结合:
- ToT 作为规划器:生成多个行动计划;
- Agent 作为执行器:调用工具验证每个 plan;
- 反馈闭环:根据执行结果更新评估,动态调整策略。
这标志着从“被动推理”走向“主动探索与验证”。
总结
思维树(ToT)不是 CoT 的替代品,而是其在复杂场景下的强力升级。它通过引入并行探索、显式评估和回溯机制,让 LLM 更像一个深思熟虑的专家,而非直觉答题者。
使用建议:
- 简单任务 → 用 CoT(高效)
- 复杂/开放/高风险任务 → 用 ToT(可靠)
掌握 ToT,你就拥有了引导 AI 进行深度思考与战略决策的能力,这是构建下一代智能系统的关键技能。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 qiqicto@qq.com 举报,一经查实,本站将立刻删除。