RAG(Retrieval-Augmented Generation,检索增强生成)是一种将信息检索与文本生成相结合的 AI 架构。其核心思想是:在大语言模型(LLM)生成回答之前,先从一个外部知识库中检索出与用户问题最相关的文档片段,并将这些片段作为上下文注入到提示词(Prompt)中。这样,LLM 的回答就能基于最新的、特定领域的事实,而非仅依赖其训练时学到的、可能已过时或不准确的内部知识。RAG 有效解决了 LLM 的“幻觉”问题和知识更新难题。
RAG 的核心组件与工作流程解析
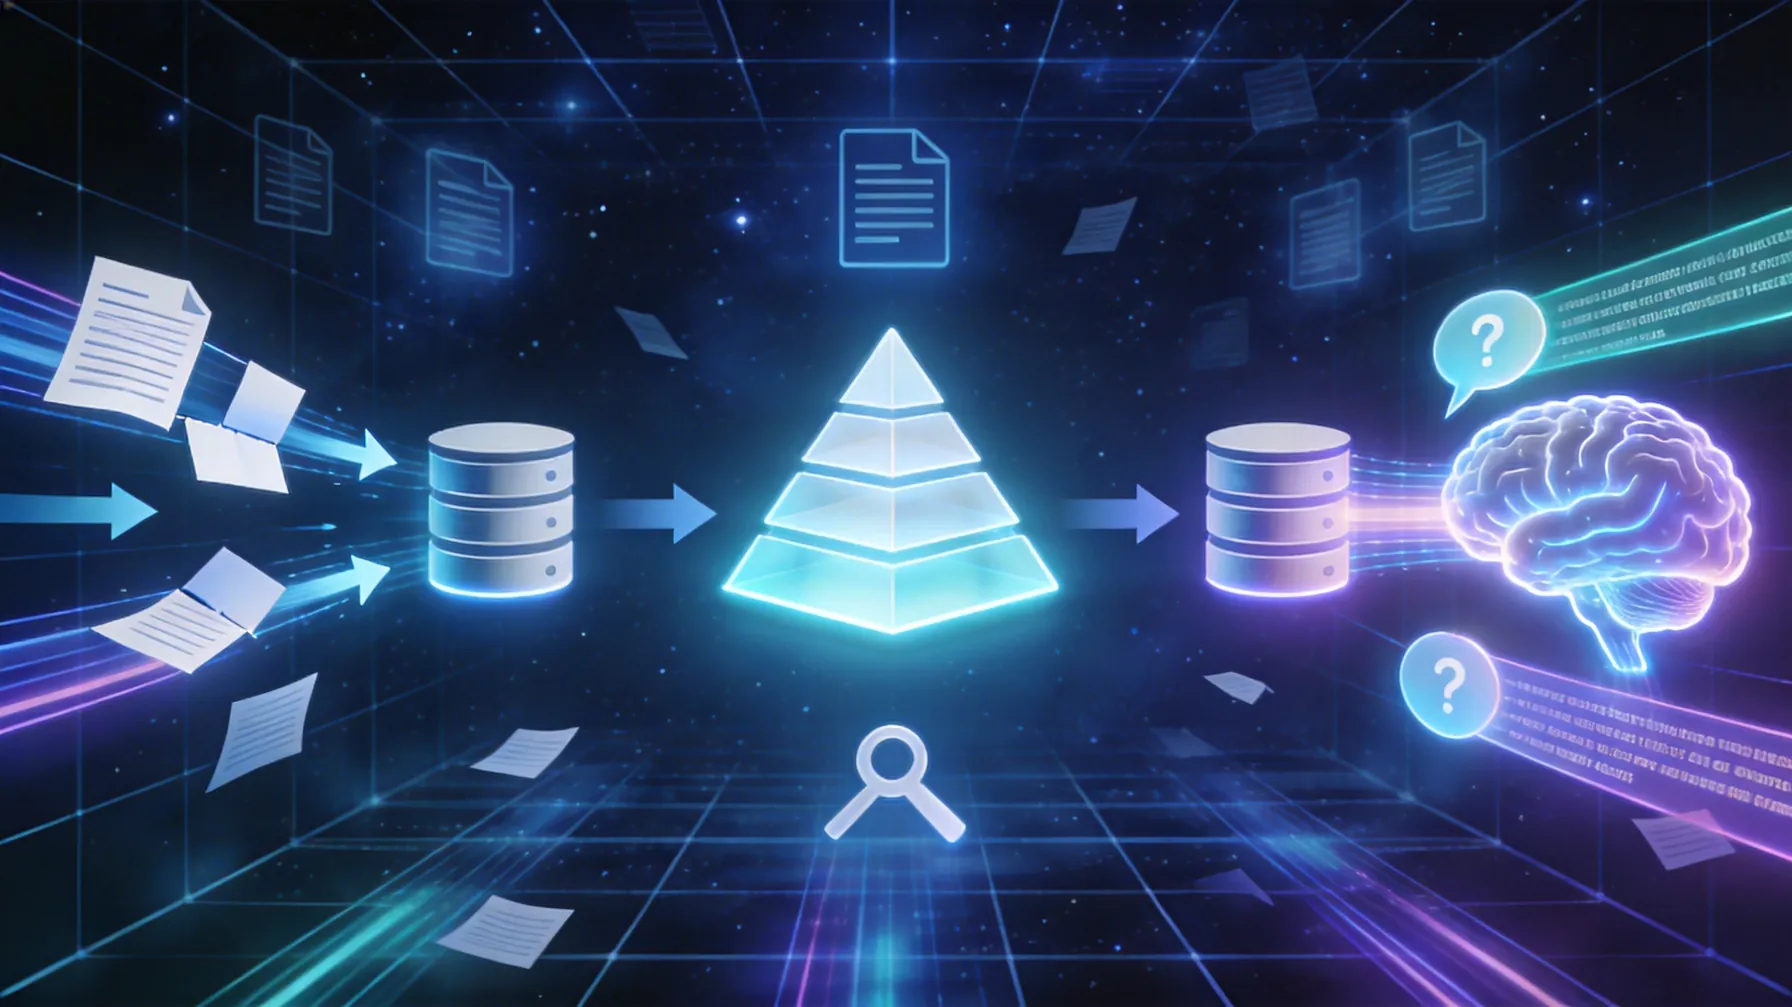
一个标准的 RAG 系统由三个关键部分构成:索引器(Indexer)、检索器(Retriever)和生成器(Generator)。
索引器负责将原始非结构化数据(如 PDF、网页、数据库记录)转换为可检索的格式。这个过程通常包括:文档加载(Document Loading)、文本分割(Text Splitting)和向量化(Embedding)。LangChain 提供了丰富的 DocumentLoader 和 TextSplitter,能处理多种文件格式。分割后的文本块(Chunks)通过嵌入模型(如 OpenAI Embeddings、Sentence Transformers)转换为高维向量,并存储在向量数据库(如 FAISS、Chroma、Pinecone)中。
检索器是 RAG 的“眼睛”。当用户提出问题时,检索器会将问题同样转换为向量,并在向量数据库中执行近似最近邻(ANN)搜索,找出语义上最相似的 Top-K 个文本块。LangChain 的 VectorStoreRetriever 封装了这一过程,开发者只需调用 retriever.invoke(query) 即可获得相关上下文。
生成器通常是 LLM 本身。它接收一个精心构造的提示词,该提示词包含两部分:检索到的相关上下文和用户的原始问题。LLM 的任务是基于提供的上下文,综合、提炼并生成一个准确、连贯的回答。整个流程形成了一个“检索-阅读-回答”的闭环。
在 LangChain 中构建 RAG 应用的标准步骤
LangChain 通过其声明式编程范式(LCEL)极大地简化了 RAG 应用的构建。官方推荐使用 create_retrieval_chain 工厂函数,它能自动组装检索和问答两个子链。
第一步:准备并索引数据
from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings
from langchain_community.vectorstores import FAISS

# 加载文档
loader = PyPDFLoader("company_handbook.pdf")
docs = loader.load()

# 分割文本
text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
splits = text_splitter.split_documents(docs)

# 创建向量存储
vectorstore = FAISS.from_documents(splits, OpenAIEmbeddings())
retriever = vectorstore.as_retriever()
这里使用了 RecursiveCharacterTextSplitter,它能智能地按字符(如 nn, n, 空格)递归分割文本,尽量保持句子的完整性。
第二步:构建问答链
from langchain import hub
from langchain_core.runnables import RunnablePassthrough
from langchain_core.output_parsers import StrOutputParser
from langchain_openai import ChatOpenAI

# 拉取社区优化的提示词模板
prompt = hub.pull("rlm/rag-prompt")

def format_docs(docs):
    return "nn".join(doc.page_content for doc in docs)

llm = ChatOpenAI(model="gpt-4-turbo", temperature=0)

# 手动构建 RAG 链(理解原理)
rag_chain = (
    {"context": retriever | format_docs, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
此代码清晰地展示了数据流向:问题同时用于检索上下文和作为最终提示词的一部分。format_docs 函数将检索到的多个文档对象拼接成一个字符串。
第三步:使用高级工厂函数简化
from langchain.chains import create_retrieval_chain
from langchain.chains.combine_documents import create_stuff_documents_chain

# 创建文档问答链
combine_docs_chain = create_stuff_documents_chain(llm, prompt)
# 创建完整的检索链
retrieval_chain = create_retrieval_chain(retriever, combine_docs_chain)

response = retrieval_chain.invoke({"input": "公司的年假政策是什么?"})
print(response["answer"])
create_retrieval_chain 返回一个字典,包含 input、context 和 answer 字段,便于调试和扩展。
RAG 的优化策略与高级技巧
基础 RAG 虽然有效,但在面对复杂查询或多跳推理时可能表现不佳。以下是几种常见的优化方向:
元数据过滤:在检索时,可以利用文档的元数据(如来源、日期、作者)进行过滤。例如,只检索 2023 年之后的政策文件。LangChain 的 VectorStoreRetriever 支持 search_kwargs 参数来传递过滤条件。
混合检索:结合向量检索(语义相似)和关键词检索(BM25)的优势,能覆盖更多相关文档。可以使用 EnsembleRetriever 将两种检索结果融合。
重排序(Re-ranking):初步检索出的 Top-K 结果可能包含噪声。使用专门的重排序模型(如 Cohere Rerank、BAAI/bge-reranker)对结果进行二次打分和排序,能显著提升上下文的相关性。
自查询检索器(Self-Query Retriever):对于结构化程度较高的数据,可以让 LLM 先解析用户问题,自动生成一个结构化的查询(包含过滤条件和自然语言查询),再执行检索。这在处理带有属性的数据集时非常有效。