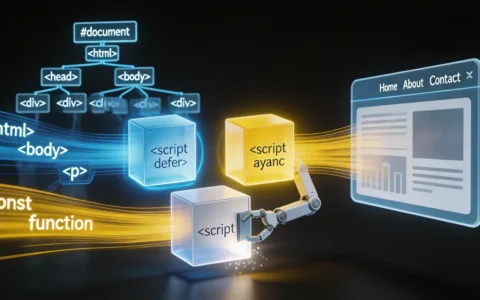
SSE(Server-Sent Events,服务器发送事件)是一条由服务器控制生命周期的持久化 HTTP 长连接,服务端把数据以事件流形式分段推给客户端,浏览器用原生 EventSource 即可接收,无需任何第三方库。AI 对话场景选 SSE 而不是 WebSocket,核心原因是对话响应是”服务器单向推送、客户端只发一次请求”的天然单向模式,而 OpenAI、Anthropic 等厂商的流式接口本身就是 SSE 格式,前后端复用同一套协议,链路最短。
一、SSE 的工作原理
1.1 一条请求,多段响应
普通 HTTP 请求是”请求一次、响应一次、连接关闭”。SSE 走的是同一套流程,区别在于服务端收到请求后不立刻关闭连接,而是持续往这条连接写数据,直到内容推完。数据遵循固定文本格式,每段以 data: 开头、空行结束:
data: 你好

data: 这是一段流式文本

data: [DONE]事件还可以携带类型、编号与重试时间等字段,event: 声明事件名、id: 标记序号、retry: 告诉浏览器重连间隔,这些字段组合起来足够表达 AI 生成中的阶段变化、进度与错误状态。
1.2 完整交互流程
- 客户端发起 GET 请求,请求头声明接受事件流;
- 服务端返回 200 响应,Content-Type 设为 text/event-stream,保持连接打开;
- 服务端每生成一段数据就写一段事件,客户端逐段解析;
- 数据推完,服务端关闭连接或发送结束标记;
- 连接意外断开时,EventSource 自动重连,并通过 Last-Event-ID 头带上最后收到的消息编号,服务端可据此补发。
大模型逐 token 生成与这套机制天然契合:模型每吐出一个词元,后端就封装成一个事件推出去,前端收到即追加渲染,用户看到的就是逐字出现的打字机效果。
二、为什么 AI 对话选择 SSE
2.1 四种方案横向对比
| 维度 | 轮询 | 长轮询 | WebSocket | SSE |
|---|---|---|---|---|
| 通信方向 | 单向 | 单向 | 双向全双工 | 单向 |
| 连接方式 | 每次新建 | 反复挂起重连 | 协议升级为独立 socket | 一条 HTTP 长连接 |
| 断线重连 | 天然轮询 | 需自建 | 需自研 | 浏览器内置 |
| 实现成本 | 低 | 中 | 高 | 低 |
| AI 流式匹配度 | 差 | 较差 | 过度设计 | 完全匹配 |
轮询在高延迟的 AI 生成场景会造成大量无效请求;WebSocket 双向能力在”客户端只发一条消息、服务端持续回推”的对话里用不上,还要自己处理握手、心跳与重连。长轮询虽然减少了请求次数,但每次推送都要重建连接,且服务端要维护挂起连接的状态,复杂度并不比 SSE 低。相比下来,SSE 在实现成本、连接开销与协议匹配度三个维度都占优,这也是多数 AI 产品把它作为默认流式通道的原因。
2.2 SSE 与 WebSocket 的关键差异
WebSocket 需要一次协议升级握手,之后变成完全独立的双向通道,适合语音通话、协同编辑这类客户端也在持续上行的场景。SSE 则建立在普通 HTTP 之上,天生对防火墙、代理、负载均衡友好,普通 HTTP 的负载策略直接可用,不需要为连接状态做粘性会话。浏览器对 EventSource 的自动重连和事件编号补发,省掉了一大段自研代码。上游大模型的流式接口也以 SSE 格式下发,后端做转发网关时透传即可,格式统一、不需要做双向协议转换。
还有一层体验因素。生成是渐进过程,用户看到文字逐字出现会产生”模型在思考”的感知,这比干等几十秒再一次性看到全文要自然得多。首字延迟从生成完成缩短到首 token 到达,聊天的真实感大幅提升。这套体验正是靠长连接把生成时延”摊薄”进用户视野。
三、在 AI 爆款文章创作器中的落地
3.1 后端用 Spring Boot 起一条流
创作器的多阶段生成(选题、大纲、正文、标题润色)会连续产出不同类型的数据,我按事件类型区分推送:
@PostMapping(value = "/api/gen/stream", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
public SseEmitter stream(@RequestBody GenRequest request) {
    SseEmitter emitter = new SseEmitter(0L); // 不设超时
    executor.execute(() -> {
        try {
            for (String stage : stages) {
                emitter.send(SseEmitter.event()
                    .name("stage")
                    .data(Map.of("type", stage)));
                String chunk = llmService.generateChunk(stage, request);
                emitter.send(SseEmitter.event().name("content").data(chunk));
            }
            emitter.complete();
        } catch (Exception e) {
            emitter.completeWithError(e);
        }
    });
    return emitter;
}
阶段事件让前端知道当前进度,内容事件承载实际文本,二者用事件名区分,Vue 侧按名监听即可。多阶段生成的编排放在异步线程里,SseEmitter 实例由控制器返回给 Spring MVC,之后线程继续生产数据,互不阻塞。生成结束时必须显式调用 complete,否则连接会一直挂着,前端永远等不到结束信号。
3.2 前端逐段渲染
浏览器用 fetch 的 reader 逐块读取,比原生 EventSource 更灵活,因为创作器需要 POST 携带参数:
const res = await fetch('/api/gen/stream', {
  method: 'POST',
  headers: { 'Content-Type': 'application/json' },
  body: JSON.stringify({ topic: this.topic })
})
const reader = res.body.getReader()
const decoder = new TextDecoder()
while (true) {
  const { done, value } = await reader.read()
  if (done) break
  const text = decoder.decode(value)
  this.article += text.replace(/^data: /gm, '')
}
四、SSE 落地的三个边界
- 代理缓冲:Nginx 等代理默认会缓冲响应,需要关闭缓冲并调长 read 超时,否则 token 会攒在代理层,流式失效;
- 心跳保活:连接空闲太久会被中间设备掐断,服务端定期推一行注释充当心跳,维持连接存活;
- 连接数量:浏览器对同一域名的 HTTP/1.1 连接数有限制,长连接占用的场景要留意;文本流之外,SSE 也不适合直接推二进制内容。
这三条在实践中逐一踩过,写下来能帮后来者少走弯路。再补一个细节:生成中途模型报错时,前文已经渲染给用户了,这时不要静默丢弃流,应推一个 error 事件说明原因,前端保留已展示的部分内容并提示重试,用户的体验损失远小于整段清空。
常见问题(FAQ)
Q1:SSE 和 WebSocket 该按什么标准选?
看方向性。服务器单向推数据选 SSE,客户端需要持续上行双向交互才选 WebSocket。
Q2:EventSource 支持 POST 请求吗?
EventSource 原生只支持 GET,POST 要改用 fetch 解析流。
Q3:流式输出怎么处理断线重连?
EventSource 自带重连,fetch 方案要自己加退避重试,配合服务端断点续传。