
凌晨告警群炸锅,带宽曲线从常态值直接顶到机房上限,业务页面集体超时——这大概率就是一次 DDoS。应对它不能靠临时抱佛脚:先搞清楚攻击为什么能打死服务器,再理解清洗体系把恶意流量丢在哪一环,最后在自建和高防之间做出匹配业务规模的取舍。
攻击为什么能打死一台服务器
DDoS 的思路并不复杂:单台机器发起的请求服务器扛得住,但成千上万台”肉鸡”同时发来请求,任何环节的容量都会被击穿。攻击者瞄准的从来不是服务器本身,而是链路上容量较小的一环——可能是带宽出口,可能是连接表,也可能是应用层的处理线程。
按攻击层次分,常见类型有三类,各自的防护思路完全不同:
| 攻击类型 | 典型手法 | 打击目标 | 防护要点 |
|---|---|---|---|
| 流量型 | SYN Flood、UDP Flood | 带宽出口、连接表 | 靠大带宽清洗中心稀释 |
| 反射放大 | DNS/NTP/Memcached 反射 | 带宽出口 | 封禁开放反射源、源地址校验 |
| 应用型 | HTTP CC、慢速连接 | Web 线程池、数据库 | 行为分析、人机验证、限频 |
三类攻击里,流量型和反射型拼的是带宽资源,应用型拼的是识别精度。很多企业买了高防 IP 之后仍然被打挂,原因往往是只防住了前两类,CC 攻击绕过清洗直接打在业务接口上。
清洗到底发生在哪一环
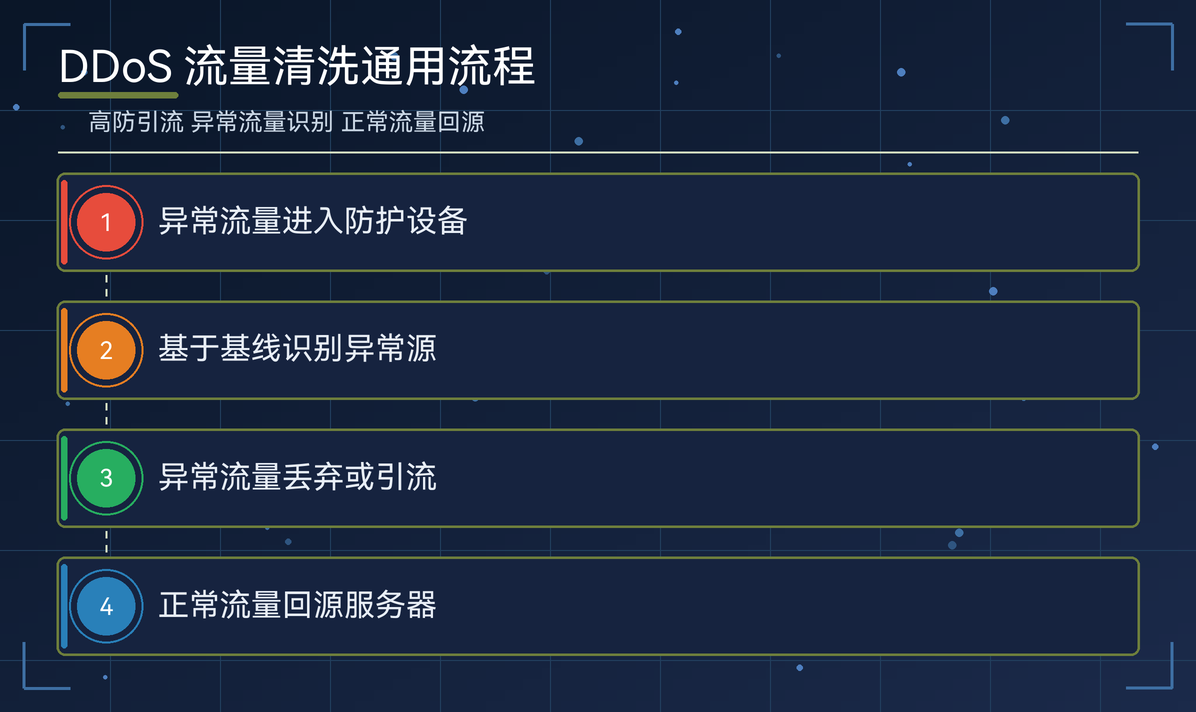
清洗体系的核心逻辑是”引流—清洗—回源”三段式。恶意流量不会直接打到源站,而是先被牵引到清洗节点,过滤后再把正常流量送回去:
- 检测触发:流量基线监控发现异常突增,自动或手动触发防护策略;
- 流量牵引:通过 BGP 协议把目标 IP 的路由牵引到清洗中心,让所有流量先经过清洗集群;
- 特征过滤:在清洗节点上丢弃明显异常的包——伪造源地址的、协议特征不符的、频率远超人类的;
- 正常回源:过滤后的流量经由专用通道回注到源站,业务方无感知。
这套机制的成立前提是”清洗节点的带宽远大于攻击流量”。这也是为什么清洗服务通常按”防护带宽”或”峰值流量”计费——买的就是清洗中心背后那份容量冗余。
自建防护和高防服务,怎么取舍
预算和业务规模不同,路径完全不同。两条路线的核心差异在容量和成本结构上:
| 维度 | 自建防护(本地设备/软件) | 高防服务(高防 IP/云清洗) |
|---|---|---|
| 防护容量 | 受限于自身出口带宽 | 清洗中心带宽池,容量以 T 计 |
| 成本结构 | 一次性设备投入 | 按防护带宽或保底值付费 |
| 擅长场景 | 应用层 CC、低频慢速攻击 | 大流量型攻击、反射放大 |
| 生效速度 | 策略即时生效 | 牵引切换有秒级到分钟级延迟 |
两条路线不是二选一。生产环境的常规组合是:高防服务兜底大流量攻击,本地 WAF 或网关限频处理应用层攻击,两层各管一段。
踩过的三个典型坑
第一,源站 IP 泄露。高防 IP 配好了,但历史 DNS 解析记录、邮件服务器出口、小程序后端配置里还留着源站真实 IP,攻击者绕过高防直接打源站,防护等于零。上线高防后要全量排查所有可能暴露源站 IP 的出口。
第二,CC 攻击当成流量攻击防。表现为带宽不高但 CPU 飙升、数据库连接打满,这是应用层攻击的特征,需要在网关层做人机验证和接口限频,而不是加带宽。
第三,防护阈值拍脑袋定。阈值设低了正常用户被误杀,设高了攻击已经打穿还没触发。合理做法是按业务历史流量基线设定,日常峰值的两到三倍作为触发线,并根据大促等业务节奏动态调整。
Nginx 侧可以先做一层应用层限频兜底,配置片段如下:
limit_req_zone $binary_remote_addr zone=api_limit:10m rate=10r/s;

server {
    location /api/ {
        limit_req zone=api_limit burst=20;
        proxy_pass http://backend;
    }
}
这段配置把单个 IP 对接口的请求压到每秒 10 次、允许 20 的突发余量,能拦住相当一部分低门槛 CC 脚本。但它是兜底而非替代——真正的攻击还是要靠清洗中心消化。
常见问题(FAQ)
Q1:怎么判断自己是被 DDoS 了还是正常流量高峰?
看流量来源分布和协议特征:来源高度分散、UDP 占比异常、单 IP 频率失真,基本可判定为攻击。
Q2:高防 IP 大概多少钱一个月?
按防护带宽和业务线路定价,从百元级基础版到万元级高防都有,按历史攻击峰值选档。
Q3:被打了之后第一件事做什么?
立即启用高防牵引,保留流量抓包证据,再排查源站 IP 是否已经暴露。

