
评估一个大模型值不值得接入,看的不是榜单名次,而是它把文本理解、内容生成、逻辑推理、工具调用这几件事分别做到了什么程度——Qwen(通义千问)系列正好提供了一个完整的观察样本。它是阿里云开源的大语言模型家族,从 0.6B 的小参数模型到万亿参数的旗舰版本形成完整谱系,本篇按通用维度讲清楚这类模型的能力边界和选型要点。
从初代开源到旗舰版本的时间线
Qwen 系列的迭代节奏在开源大模型里属于密集型,版本线本身就能看出这条技术路线的演化方向:
| 时间 | 版本节点 | 关键信息 |
|---|---|---|
| 2023 年 | 初代 Qwen 开源 | 覆盖 1.8B 至 72B,奠定中英双语基础 |
| 2024 年 | Qwen2 / Qwen2.5 | 预训练数据扩展至 18T tokens 量级,长上下文增强 |
| 2025 年 4 月 | Qwen3 开源 | 约 36T tokens、覆盖 119 种语言,Apache 2.0 协议 |
| 2025 年 7 月 | Qwen3-Coder 开源 | 代码方向专项模型 |
| 2026 年 2 月 | Qwen3.5 开源 | 引入线性注意力等混合架构,推理效率提升 |
| 2026 年 8 月 | Qwen3.8 开源版发布 | 总参数 2.4T、激活约 95B 的稀疏 MoE,支持百万级上下文 |
两个节点值得展开。一是 2025 年 4 月的 Qwen3:它把”深度思考”和”快速回答”做成了可切换的混合模式——难题让模型逐步推理,简单问题直接出答案,推理预算由调用方控制,这是后来各家模型普遍跟进的形态。二是 2026 年的 Qwen3.8:旗舰云版本采用稀疏混合专家架构,2.4T 总参数里每次前向只激活约 95B,兼顾了规模与推理成本,随后开源的版本把权重开放给社区自部署。
| 参数量级 | 典型用途 | 部署门槛 |
|---|---|---|
| 0.6B-4B | 端侧设备、嵌入式、简单分类抽取 | 消费级显卡甚至 CPU |
| 8B-32B | 企业内网知识库、中等复杂度任务 | 单卡到双卡推理 |
| MoE 旗舰 | 复杂推理、Agent 编排、代码生成 | 多卡集群或直接调用云 API |
这类模型到底能做什么
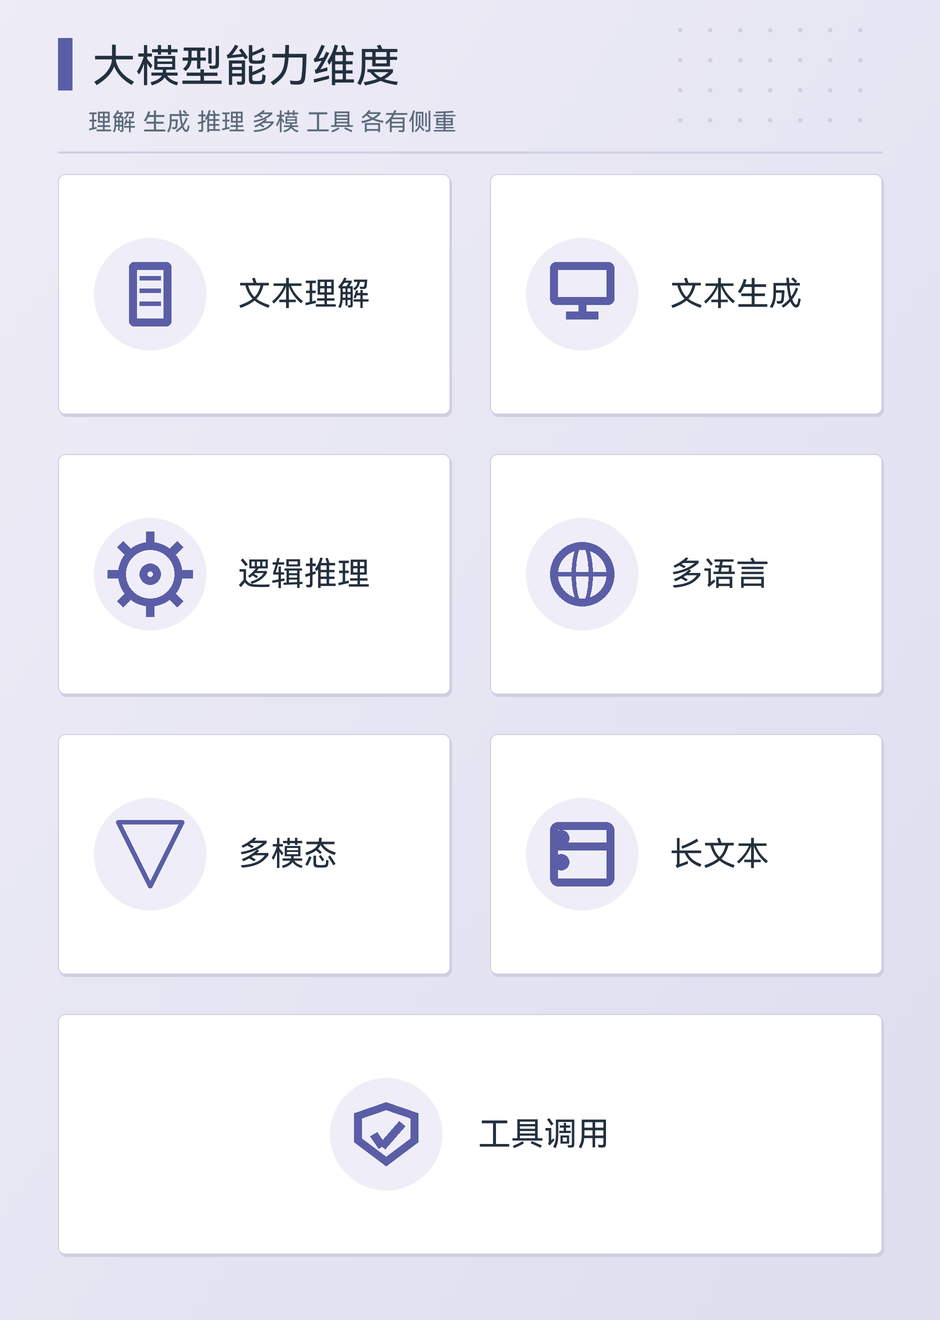
抛开版本号,一个现代大模型的能力面可以拆成六个维度,选型时逐项对照业务需求即可:
- 文本理解:长文档摘要、意图识别、信息抽取,这是全部上游能力的基础;
- 内容生成:写作、翻译、润色,质量取决于预训练语料的覆盖面;
- 逻辑推理:数学、代码、多步规划,与”思考模式”的深度直接相关;
- 多语言:跨语言理解与生成,Qwen3 起官方口径覆盖 119 种语言与方言;
- 多模态:部分分支模型支持图像、音频、视频的输入理解;
- 工具调用:按约定格式生成函数调用参数,是搭建 Agent 应用的前提。
六个维度里,业务方感知差异较大的是推理和工具调用两项。推理能力决定模型能不能独立完成多步骤任务;工具调用则决定它能不能从”聊天”升级成”干活”——调用搜索引擎、查数据库、操作系统 API,都靠这一层协议支撑。
接入方式上,开源权重可以下载后用 vLLM、SGLang 等推理框架自部署,也可以直接走 OpenAI 兼容协议调用云端 API。后者几十行代码就能跑通:
from openai import OpenAI

client = OpenAI(
    api_key="your-api-key",
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

resp = client.chat.completions.create(
    model="qwen-plus",
    messages=[{"role": "user", "content": "用一句话解释什么是混合专家架构"}],
)
print(resp.choices[0].message.content)
兼容协议的好处是换模型不改代码:业务层只面向 chat.completions 接口,底层在不同模型之间切换时,改动通常只有 model 参数一个字段。
从零把一个开源版本跑起来,落地路径通常是四步:
- 按任务规模选定参数量级,小任务从 4B-8B 起步试水;
- 下载权重后用 vLLM 或 Ollama 起推理服务,先跑通官方示例对话;
- 用业务真实语料做小批量评测,对比候选模型在自家任务上的输出质量;
- 确定选型后再封装成 OpenAI 兼容接口接入业务,同时压测并发与显存水位。
四步里第 3 步不建议省:公开榜单分数和自家任务表现经常对不上,几十条真实样本的人工对比,比任何榜单都更接近上线后的真实效果。
选型时该看哪几个指标
参数量之外,真正影响落地效果的是四件事:上下文长度决定单次能喂进去多少资料;许可证条款决定商用是否需要额外授权——Apache 2.0 系对商用友好,部分旗舰开源版对超大规模商用另有约定;思考模式的开关与预算控制直接影响推理成本;部署生态的成熟度(vLLM、Ollama 等框架的适配速度)决定从下载到跑通要多久。
经验性结论是:简单分类抽取任务用小参数模型就够,成本可以压一个数量级;复杂推理和 Agent 编排再上大参数或 MoE 旗舰。按任务难度分层调用,比全链路堆旗舰模型划算得多。
常见问题(FAQ)
Q1:Qwen 开源版本商用怎么确认授权?
Apache 2.0 协议的版本可自由商用,旗舰开源版对超大规模服务商另有条款,部署前查许可证原文。
Q2:本地部署 8B 模型要多少显存?
FP8 或 4bit 量化后 8-12GB 显存可跑,FP16 全精度需 16GB 以上。
Q3:为什么简单任务不建议上旗舰模型?
小参数模型在分类抽取类任务上效果接近,推理成本能压一个数量级,按任务难度分层更划算。

