一个字节由 8 位二进制位组成,能表示 2 的 8 次方共 256 种状态——这个约定从 20 世纪 60 年代定型沿用至今,是所有存储容量、传输速率、字符编码的换算基准。但”为什么偏偏是 8 位”以及”1 个汉字占几个字节”这两个衍生问题,才是日常开发里真正容易踩坑的地方。
字节为什么定格在 8 位
字节(Byte)不是天生的 8 位。早期计算机的字节宽度五花八门,有 6 位、7 位也有 9 位的——各厂商按自己的字符集和硬件设计自行定义。转折点出现在 20 世纪 60 年代:IBM System/360 主机系列采用 8 位字节并将其推广到整个行业,8 位恰好能容纳扩展字符集的一个字符,又方便按 2 的幂对齐内存设计,这个尺寸从此被固定下来并写入国际标准。
8 位带来的 256 种状态,刚好覆盖了英文大小写字母、数字、标点和控制字符,还有充足的扩展空间。对硬件设计而言,8 是 2 的三次方,内存寻址、寄存器位宽都容易对齐,工程上的顺手程度远超 7 位或 9 位。
从”8 位”这个事实出发,可以顺着一条链把计算机的分层结构串起来:
- 1 个字节 = 8 个二进制位(bit),能表示 0 到 255 的无符号整数;
- 半个字节称 4 位(nibble),一位十六进制数字恰好对应一个 nibble;
- 若干字节组成字(Word),32 位系统的字长是 4 字节,64 位是 8 字节;
- 字符通过编码表映射到字节序列,才有了屏幕上看到的文字;
- 字节序列再往上组织成 KB、MB、GB,构成存储容量的度量体系。
这条链解释了为什么字节是理解计算机系统的锚点:往下单是电路里的高低电平,往上是用户看到的一切数据,中间的每一次换算都经过它。
字符编码:1 个字符不等于 1 个字节
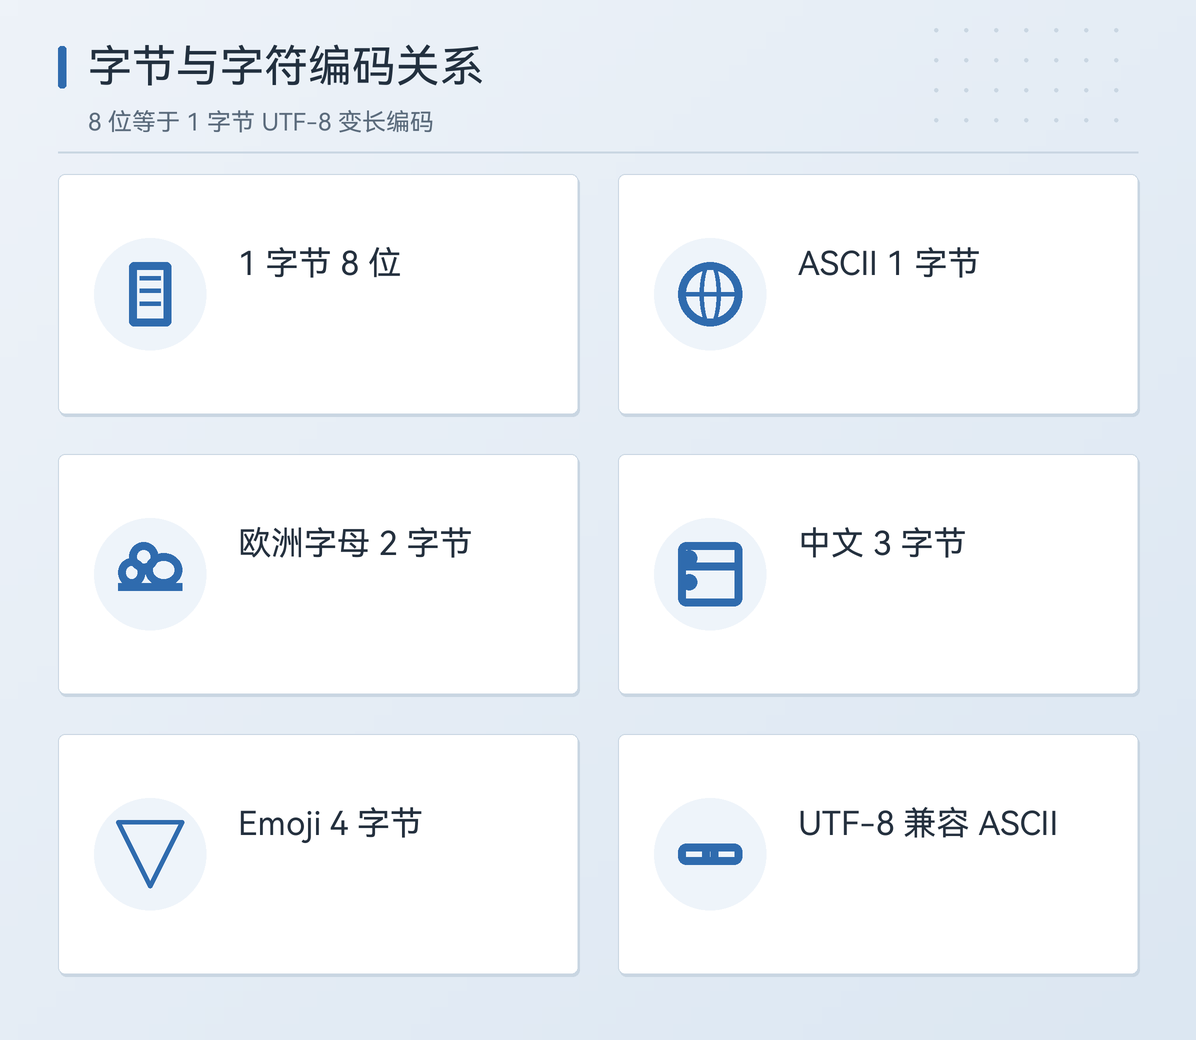
字节和字符是两层概念:字节是存储单位,字符是人眼看到的符号。一个字符占几个字节,取决于用的是哪种编码。这是跨语言开发里出错频率极高的一处:
| 字符类型 | ASCII 编码 | UTF-8 编码 |
|---|---|---|
| 英文字母/数字 | 1 字节 | 1 字节 |
| 拉丁扩展字母(é、ü 等) | 不支持 | 2 字节 |
| 常用汉字 | 不支持 | 3 字节 |
| 生僻字/Emoji | 不支持 | 3-4 字节 |
UTF-8 是变长编码:英文字符仍然只用 1 字节(与 ASCII 完全兼容),字符越”偏远”占用越多。这解释了两个经典现象——同一份文档,英文版比中文版体积小很多;len() 函数统计的字符数和文件字节数对不上。
用 Python 验证一遍最直观:
s = "A中😀"
print(len(s))                    # 3,字符数
print(len(s.encode("utf-8")))    # 1 + 3 + 4 = 8,字节数
print(len(s.encode("gbk")))      # 1 + 2 + 4 = 7,GBK 下汉字占 2 字节
同一个字符串在三种口径下得到三个不同的”长度”。做文件传输、数据库字段设计、接口报文限长时,先问清楚限制的是字符数还是字节数,再确认编码,能省掉大量乱码和截断类故障。
存储单位换算里的两套口径
字节往上走是 KB、MB、GB,但这里存在两套换算标准,混用时误差会累积到肉眼可见的程度:
| 单位 | 二进制标准(IEC) | 十进制标准(SI) |
|---|---|---|
| 1 KB | 1024 字节(KiB) | 1000 字节 |
| 1 MB | 1024 KB | 1000 KB |
| 1 GB | 1024 MB | 1000 MB |
操作系统习惯按 1024 进位显示容量,硬盘厂商按 1000 进位标注规格,这就是”买 1TB 硬盘到手只有 931GB 左右”的由来——容量没有少,是两套口径的呈现差异。严格的标准写法里,1024 进位的单位应写作 KiB、MiB、GiB,但日常语境中 KB=1024 字节仍是约定俗成。
网络带宽同样按十进制算:100Mbps 宽带的理论峰值是 100 除以 8 等于 12.5MB/s(此处 MB 按 1000 进位),实测低于该值属正常,因为还有协议开销和线路损耗。
回到实际工作场景,字节概念直接对应三类高频问题:数据库建 VARCHAR 字段时按字节还是字符限长,直接决定中文数据会不会被截断;日志采集和消息队列的限流配额按字节计,中文日志的膨胀系数要提前估算;跨国接口报文用 UTF-8 传输时,压测带宽要按”字符数乘平均字节数”估算而不是字符数本身。把字节和字符分清楚,这些问题在方案阶段就能规避掉。
常见问题(FAQ)
Q1:为什么字节是 8 位而不是 10 位?
8 位是 2 的幂便于硬件对齐,且 256 种状态够容纳扩展字符集,由 IBM System/360 推广定型。
Q2:1 个汉字占多少字节?
UTF-8 下常用汉字占 3 字节,GBK 下占 2 字节,生僻字和 Emoji 在 UTF-8 下可达 4 字节。
Q3:1KB 怎么换算成字节?
两套标准并存:存储行业按 1000(SI),操作系统和内存按 1024(IEC 的 KiB)。