在当今数字化和信息化的时代,机器学习已成为推动技术创新和社会发展的重要力量。机器学习算法的种类繁多,每种算法都有其独特的特点和适用场景。以下将介绍一些常见的机器学习算法及其常见的应用领域。
一、线性回归(Linear Regression)
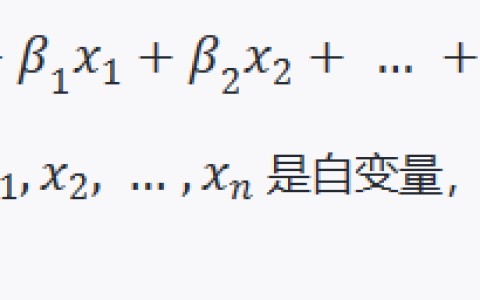
线性回归是一种用于预测连续数值型数据的监督学习算法。它通过建立自变量和因变量之间的线性关系模型,来预测因变量的值。
应用场景:
- 房地产价格预测:基于房屋面积、地理位置、房间数量等特征预测房价。
- 销售预测:根据历史销售数据和相关因素(如季节、促销活动)预测未来的销售量。
- 股票价格走势估计:利用公司的财务指标和市场因素来预估股票价格的未来走向。
二、逻辑回归(Logistic Regression)
逻辑回归虽然名字中有“回归”,但它常用于解决二分类问题,将线性回归的结果通过逻辑函数映射到[0, 1]范围内,得到属于不同类别的概率。
应用场景:
- 信用卡欺诈检测:判断一笔交易是否为欺诈行为。
- 邮件垃圾过滤:区分一封邮件是正常邮件还是垃圾邮件。
- 疾病诊断:预测患者是否患有某种疾病。
三、决策树(Decision Tree)
决策树是一种基于树形结构的分类和回归算法。通过对特征的条件判断逐步进行分支,直到达到叶节点得出结论。
应用场景:
- 客户流失预测:分析客户的行为特征,判断其是否会流失。
- 质量检测:在生产线上根据产品的各项指标判断是否合格。
- 金融风险评估:综合考虑多个因素评估借款人的信用风险。
四、随机森林(Random Forest)
随机森林是由多个决策树组成的集成学习算法。对训练数据进行有放回抽样,构建多棵决策树,并综合考虑它们的预测结果。
应用场景:
- 图像识别:准确识别图像中的物体。
- 推荐系统:为用户推荐个性化的内容或产品。
- 信用评分:更精确地评估个人或企业的信用状况。
五、支持向量机(Support Vector Machine,SVM)
支持向量机在高维空间中寻找能够最大化不同类别数据点间隔的超平面,实现分类或回归。
应用场景:
- 文本分类:如新闻文章的主题分类。
- 生物信息学:基因表达数据的分析和分类。
- 手写数字识别:识别手写数字图片。
六、K-均值聚类(K-Means Clustering)
K-均值聚类是一种无监督学习算法,将数据集划分为 K 个簇,使得簇内的数据点相似度较高,簇间的数据点相似度较低。
应用场景:
- 市场细分:将消费者按照消费行为和特征进行分类。
- 图像压缩:对图像像素进行聚类以减少数据量。
- 异常检测:发现数据中的异常点或离群值。
七、K-近邻算法(K-Nearest Neighbors,KNN)
K 近邻算法是一种基于实例的学习,对于新的数据点,在训练集中找到与其最近的 K 个邻居,根据这些邻居的类别来决定新数据点的类别。
应用场景:
- 手写体识别:判断手写的字母或数字属于哪个类别。
- 推荐系统:根据相似用户的喜好进行推荐。
- 医疗诊断辅助:参考类似病例的特征来辅助诊断。
八、神经网络(Neural Network)
神经网络模拟了人类大脑神经元之间的连接方式,具有强大的学习和表示能力。
应用场景:
- 语音识别:将声音信号转换为文本。
- 自然语言处理:如机器翻译、情感分析等。
- 图像生成:创造逼真的图像或艺术作品。
九、梯度提升树(Gradient Boosting Tree)
梯度提升树是一种通过逐步构建弱学习器并加权组合来提高模型性能的集成算法。
应用场景:
- 风险预测:如信贷违约风险、保险理赔风险评估。
- 销量预测:结合多种因素更精准地预估产品销量。
- 网络流量预测:提前规划网络资源分配。
在实际应用中,选择合适的机器学习算法并非易事,需要综合考虑多个因素,如数据的特征、问题的类型、计算资源、模型的准确性和解释性等。同时,往往需要对数据进行清洗、预处理和特征工程,以提高模型的性能。
此外,随着技术的不断发展,新的机器学习算法和变体也在不断涌现,为解决更复杂的问题提供了更多的可能性。例如,深度学习中的卷积神经网络(CNN)在图像识别领域取得了令人瞩目的成就,循环神经网络(RNN)及其变体长短期记忆网络(LSTM)和门控循环单元(GRU)在处理序列数据方面表现出色。
总之,机器学习算法的应用已经渗透到了我们生活的方方面面,从日常的手机应用到关键的工业生产,从医疗保健到金融服务,它们正在不断改变着我们的世界,为我们带来更高效、更智能的生活和工作方式。
未来,随着数据量的持续增长和计算能力的不断提升,机器学习将在更多领域发挥更大的作用,解决更加复杂和具有挑战性的问题,推动人类社会迈向智能化新时代。