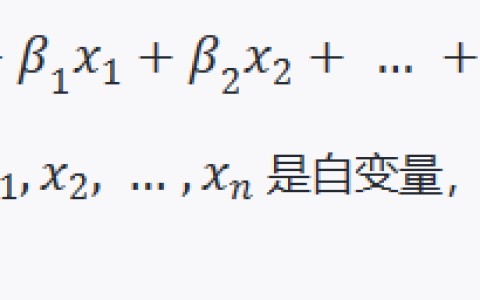
降维是数据科学中的一个重要概念,指的是在不显著损失信息的情况下,将高维数据转化为低维数据的过程。这一过程在机器学习、统计学和数据分析中扮演着关键角色。随着现代技术的发展,人们能够收集和处理的数据量呈指数级增长,这些数据通常具有多个维度,如在图像处理中,每个像素点都可以视为一个维度。在面对这样的大规模多维数据时,降维技术显得尤为重要。
降维不仅仅是为了减少数据的维度,更重要的是帮助我们理解数据结构,提取潜在的重要信息,并提高算法的效率和性能。在高维空间中,数据往往是稀疏的,这种稀疏性使得许多传统的分析方法难以奏效,如计算距离、密度等。因此,降维可以看作是一种数据预处理技术,能够帮助我们更好地应用后续的分析和建模手段。
降维的需求主要源于几个方面。首先是“维度诅咒”的问题。在高维空间中,数据点之间的距离趋于等同,这意味着对于大多数机器学习算法来说,区分数据点变得困难。此外,高维数据需要更多的存储空间和计算资源来处理,这对于许多实际应用场景来说是不可承受的。而通过降维,我们可以在保留数据特征的同时,减少数据的复杂性,从而降低存储和计算的要求。
其次,降维有助于数据可视化。在二维或三维空间中,人类可以直观地观察和理解数据的分布和结构。然而,当数据的维度超过三维时,直接可视化变得不再可能。降维技术通过将高维数据投影到低维空间中,使得我们可以通过简单的图形展示数据的内在关系,从而帮助识别数据中的模式和异常。
降维的方法主要可以分为线性降维和非线性降维。线性降维方法中最为经典的是主成分分析(PCA)。PCA通过寻找数据中方差最大的方向,将数据投影到这些方向上,以此实现降维。这种方法假设数据的主要信息集中在方差大的方向上,因此通过保留这些方向的信息,可以在很大程度上保留原始数据的结构和特征。PCA的计算相对简单,且具有较好的解释性,因此被广泛应用于各种数据分析任务中。
非线性降维方法则适用于那些线性方法难以处理的复杂数据集。例如,t-SNE(t-distributed Stochastic Neighbor Embedding)是一种常用的非线性降维技术,特别适合处理大规模、高维的嵌入式数据。t-SNE通过最小化高维和低维空间中数据点之间的概率分布差异,使得相似的数据点在低维空间中更接近,而不同类的数据点则彼此远离。这种方法在数据的可视化上表现尤为出色,常用于展示高维数据的聚类结果。
然而,降维过程也不是没有代价的。由于降维会丢失部分信息,因此选择合适的降维方法和目标维度至关重要。过度降维可能导致重要信息的丢失,影响后续的分析和决策。因此,在实施降维时,需要在信息损失和简化数据之间找到平衡。
总的来说,降维是一项强大的工具,可以帮助研究者和工程师更有效地处理和理解高维数据。在面对日益复杂的数据集时,掌握降维技术不仅能提高分析效率,还能揭示数据中隐藏的模式和结构,为深入的研究和应用提供支持。无论是在机器学习、数据挖掘,还是在生物信息学、金融分析等领域,降维都发挥着不可替代的作用。通过合理应用降维技术,我们能够在信息的海洋中提炼出关键的洞见,以指导科学研究和商业决策。