在使用大语言模型(LLM)如 GPT、Claude、通义千问等时,Token 是衡量文本长度和计费的基本单位。理解 Token 的本质、计算方式及控制策略,不仅关系到 API 成本,更直接影响模型能否完整处理输入内容或生成预期长度的输出。尤其当遇到“超出最大上下文长度”错误时,掌握 Token 管理技巧显得尤为重要。
Token 的定义与编码原理
Token 并非简单的“字”或“词”,而是文本经过分词器(Tokenizer)。分词器将原始字符串切分为模型可识别的最小语义单元,这些单元即为 Token。
不同语言和模型采用不同的分词策略:
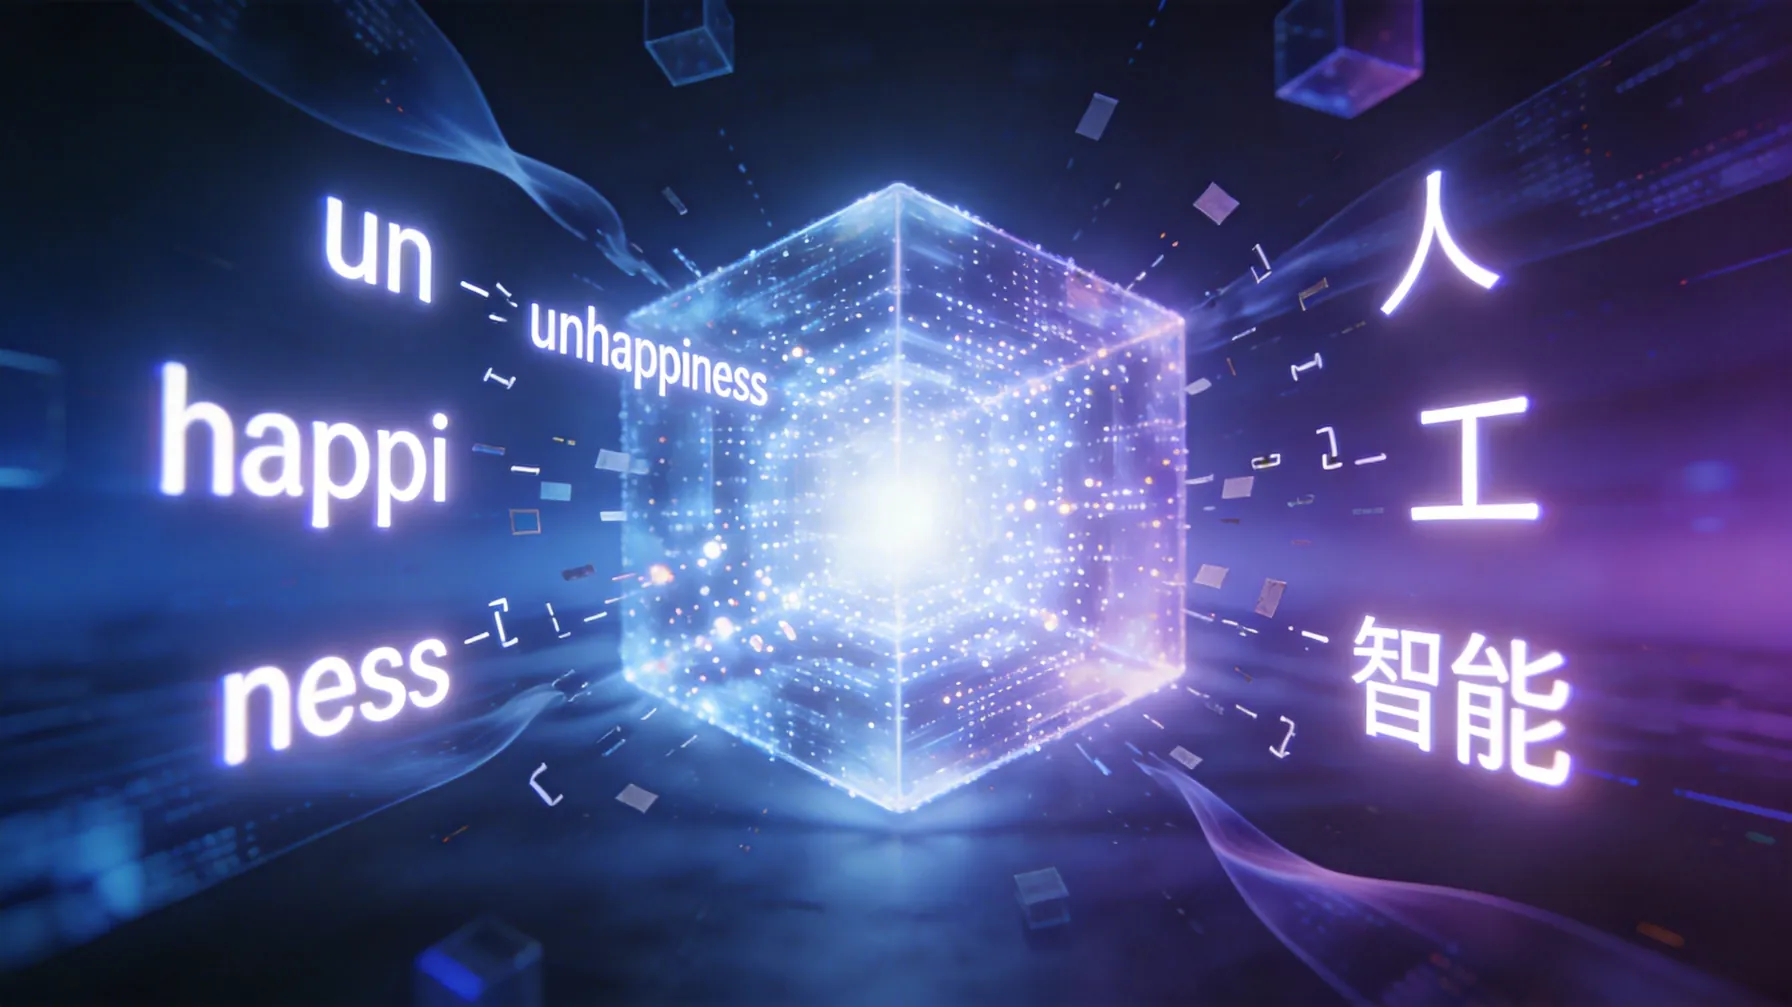
- 英文:通常按单词、标点甚至子词(subword)切分。例如,“unhappiness” 可能被分为
["un", "happi", "ness"]; - 中文:由于无空格分隔,主流模型(如 GPT 系列)多采用基于字或短语的切分。例如,“人工智能”可能被切为
["人", "工", "智能"]或作为一个整体 Token(取决于训练数据和分词器); - 代码/符号:特殊字符、缩进、换行符等也会被单独或组合编码为 Token。
以 OpenAI 的 GPT 模型为例,其使用 **Byte Pair Encoding **(BPE) 分词算法,在字节级别进行压缩和切分,兼顾了词汇覆盖率与序列长度效率。
如何准确计算 Token 数量?
官方工具推荐
最可靠的方式是使用模型提供商提供的官方 Token 计算工具:
- OpenAI:提供 tiktoken Python 库;
- **Anthropic **(Claude):提供 tokenizer 在线工具或 JS 库;
- Hugging Face:通过
transformers库加载对应模型的 tokenizer 进行编码。
示例(使用 tiktoken):
import tiktoken
enc = tiktoken.get_encoding("cl100k_base")  # GPT-4 使用的编码
tokens = enc.encode("你好,世界!")
print(len(tokens))  # 输出 Token 数量
经验估算(仅作参考)
若无法使用工具,可粗略估算:
- 英文:1 个 Token ≈ 4 个字符 或 0.75 个单词;
- 中文:1 个汉字 ≈ 1~2 个 Token(多数现代模型已优化,常为 1:1);
- 标点、空格、换行均计入 Token。
但此方法误差较大,正式开发中务必使用官方 tokenizer。
为何要控制 Token 数量?
- 上下文窗口限制:每个模型有最大上下文长度(如 GPT-4 Turbo 为 128K,GPT-3.5 为 16K)。输入 + 输出总 Token 数不能超过此限制,否则报错;
- 成本控制:多数 API 按输入和输出的 Token 总数计费,减少无效 Token 可显著降低成本;
- 性能与质量:过长的上下文可能稀释关键信息,影响模型注意力分配,导致输出质量下降。
控制 Token 数量的有效策略
1. 精简输入内容
- 移除无关描述、重复信息或冗余格式;
- 将长文档分段处理,配合摘要或关键句提取;
- 使用结构化数据(如 JSON)替代自然语言描述,减少冗余词。
2. 明确限制输出长度
在 Prompt 中显式指定输出 Token 上限或字数:
“请用不超过 100 字总结以下文章……”
“response length: max 150 tokens”
同时,调用 API 时可通过参数控制,如 OpenAI 的 max_tokens。
3. 动态截断与滑动窗口
对于超长文档(如 PDF、日志),可采用:
- 前截断:保留开头关键部分(适用于摘要任务);
- 后截断:保留最新内容(适用于聊天历史);
- 滑动窗口:分块处理并合并结果(需设计重叠区域避免信息断裂)。
4. 利用 Embedding + 向量检索(RAG)
当需从大量文本中获取信息时,不必将全文塞入 Prompt。可先用 Embedding 模型将文档向量化,通过相似度检索出最相关的片段,再将其作为上下文输入 LLM。这既能控制 Token,又能提升回答准确性。
5. 监控与日志记录
在生产环境中,记录每次请求的 input/output Token 数,分析分布规律,识别异常高消耗请求,持续优化 Prompt 和数据预处理流程。
常见误区提醒
- 误以为“字数 = Token 数”:中文用户尤需注意,不同模型对汉字的编码方式不同;
- 忽略系统消息和 Prompt 模板的 Token 开销:角色设定、指令文本同样占用上下文;
- 未预留输出空间:若输入占满 16K,模型无法生成任何回复。
总结
Token 是大模型交互的“计量单位”,其计算依赖于具体分词器,不可凭直觉估算。通过工具精确测量、精简输入、限制输出、结合检索增强等手段,可有效控制 Token 使用,在成本、性能与效果之间取得平衡。随着上下文窗口不断扩展(如 128K、1M Token 模型出现),合理管理 Token 仍是保障稳定性和经济性的基础能力。