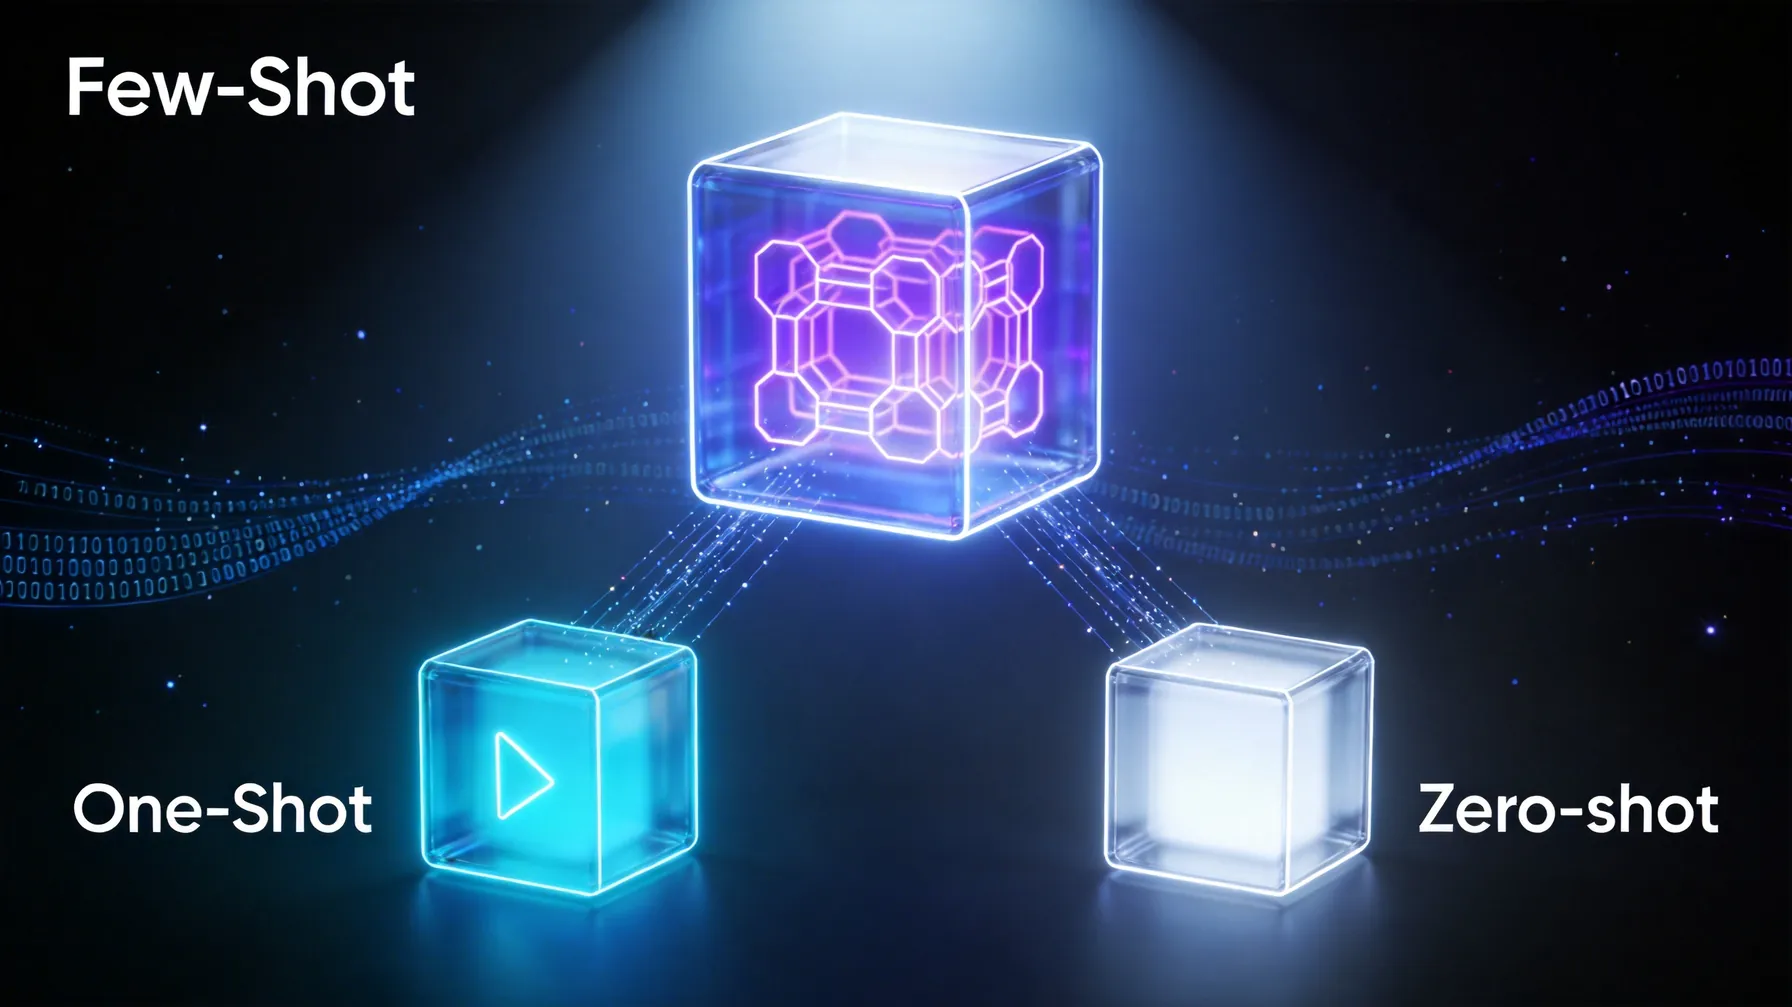
在大语言模型(LLM)的应用中,Few-shot Learning(少样本学习)是一种通过在提示词(Prompt)中提供少量示例(examples),引导模型理解任务格式与逻辑,从而在未见过的新输入上完成同类任务的技术。它与 Zero-shot(零样本)和 One-shot(单样本)共同构成了基于上下文学习(In-Context Learning)的主要范式。理解三者的区别与适用场景,是高效利用大模型能力的关键。
核心概念定义
Zero-shot(零样本)
模型仅根据任务描述(无任何示例),直接对新输入进行推理。
示例:
“将以下英文句子翻译成中文:The weather is beautiful today.”
模型需依靠预训练阶段学到的“翻译”概念完成任务,无具体格式示范。
✅ 优点:无需示例,简洁高效。
❌ 缺点:对复杂、模糊或非常规任务容易出错。
One-shot(单样本)
在任务描述后提供一个输入-输出示例,再给出新输入要求模型模仿。
示例:
示例:
输入:“Hello, how are you?” → 输出:“你好,你好吗?”
请翻译: “Good morning!”
模型通过单一案例推断任务模式(如语言对、标点处理等)。
✅ 优点:比 zero-shot 更可靠,尤其对格式敏感任务。
❌ 缺点:单一样本可能具有偶然性,泛化能力有限。
Few-shot(少样本)
提供多个(通常 2~10 个)典型示例,形成“模式模板”,显著提升模型对任务意图和输出结构的理解。
示例:
请根据用户情绪分类为 positive / negative / neutral:
“今天中奖了!” → positive
“快递又延迟了。” → negative
“会议在3点开始。” → neutral“这个电影太无聊了。” →
模型从多组样例中归纳规则(如感叹号常表积极、抱怨词表消极等)。
✅ 优点:大幅提高准确率与格式一致性,适用于复杂映射任务。
❌ 缺点:占用更多上下文 Token,增加成本与延迟。
本质区别:上下文中的“教学样本”数量
| 类型 | 示例数量 | 是否提供输入-输出对 | 适用场景 |
|---|---|---|---|
| Zero-shot | 0 | 否 | 简单、通用任务(如基础翻译、常识问答) |
| One-shot | 1 | 是 | 需要格式示范但规则简单的任务 |
| Few-shot | ≥2 | 是 | 复杂、模糊、自定义格式或领域特定任务 |
💡 关键洞察:大模型本身不进行参数更新(即非传统机器学习中的“训练”),而是通过示例激活其预训练知识中的相关模式,实现“推理时学习”。
实际应用场景对比
场景1:情感分析
- Zero-shot:
“判断以下评论的情感倾向:‘服务态度极差!’”
→ 可能输出“负面”“差”“消极”等不一致格式。 - Few-shot:
“‘很好!’ → positive;‘一般般’ → neutral;‘糟糕透顶’ → negative”
→ 输出严格统一为positive/neutral/negative。
场景2:数据提取
- Zero-shot:
“从邮件中提取电话号码。”
→ 可能遗漏或格式错误。 - Few-shot:
“邮件:‘请联系我 1381234’ → 1381234”
“邮件:‘电话:010-88889999’ → 010-88889999”
→ 模型学会识别多种电话格式并标准化输出。
场景3:代码生成
- One-shot 可展示函数签名与注释风格;
- Few-shot 可演示异常处理、日志记录、参数校验等完整模式。
使用 Few-shot 的最佳实践
- 示例应具代表性:覆盖主要边界情况(如空值、极端值、多语言);
- 保持格式严格一致:输入/输出分隔符、缩进、标点需统一;
- 按难度或频率排序:先简单后复杂,或先高频后低频;
- 避免误导性示例:错误或模糊样本会污染模型判断;
- 结合指令说明:在示例前添加清晰任务描述,如“请按以下格式转换:”。
局限性与注意事项
- Token 成本:每个示例都消耗上下文长度,超长任务需权衡示例数量;
- 并非万能:若任务超出模型知识范围(如最新事件),few-shot 也无法解决;
- 示例质量 > 数量:2 个高质量示例通常优于 5 个杂乱示例;
- 领域适配:通用示例在专业领域(如医疗、法律)效果有限,需领域定制。
总结
- Zero-shot:靠“猜”,适合简单任务;
- One-shot:给“一个例子”,适合格式示范;
- Few-shot:给“几个例子”,适合复杂、自定义或高精度要求任务。
在实际开发中,建议优先尝试 zero-shot,若效果不佳再逐步引入 one-shot 或 few-shot。同时,可将 few-shot 示例模板化,结合动态数据填充,构建稳定可靠的 AI 工作流。