在大语言模型(LLM)应用中,Few-shot Learning 通过提供少量输入-输出示例来引导模型理解任务逻辑,但示例的质量、结构与代表性远比数量更重要。一个精心设计的 Few-shot 提示,往往比堆砌多个平庸示例更能显著提升准确率、格式一致性和泛化能力。本文将系统解析如何科学选择与设计 Few-shot 示例,最大化提示效果。
一、Few-shot 示例的核心设计原则
1. 任务对齐性:示例必须精准反映目标任务
示例应覆盖任务的核心意图、输入类型和输出格式。避免“看似相关实则偏离”的例子。
✅ 正确示例(情感分类):
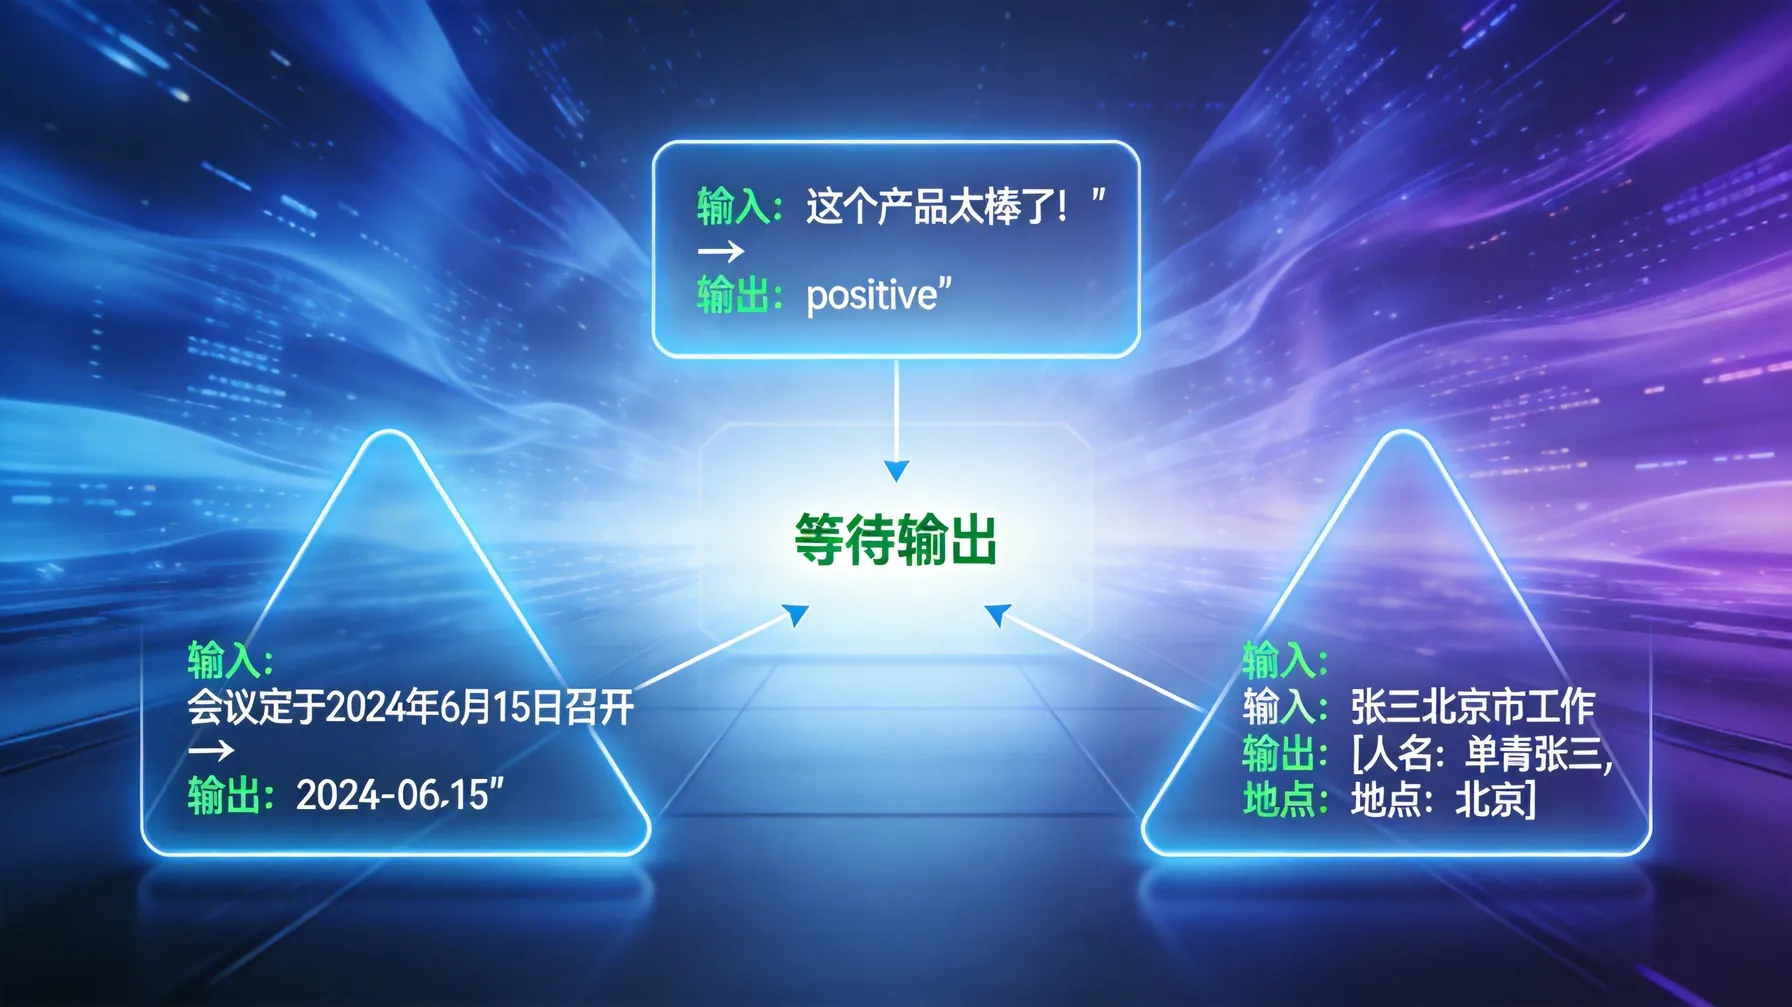
“这个产品太棒了!” → positive
“完全不值这个价。” → negative
❌ 错误示例:
“今天是星期一。” → neutral(虽正确,但未体现情感关键词)
关键:示例应突出任务判别特征(如情感词、实体类型、结构模式)。
2. 多样性与覆盖性:涵盖典型场景与边界情况
理想示例集应包含:
- 主流情况(高频模式);
- 边缘情况(如空输入、极端值、歧义句);
- 易错类型(模型常混淆的类别)。
示例:日期提取任务
“会议定于2024年6月15日召开。” → 2024-06-15
“截止到明天。” → [需结合当前日期推理]
“没有明确时间。” → null
通过覆盖“标准格式”“相对时间”“无时间”三类,提升鲁棒性。
3. 格式一致性:严格统一输入/输出结构
所有示例必须使用完全相同的分隔符、标点、大小写和数据类型,避免模型学习到噪声。
✅ 推荐格式:
输入:“文本A” → 输出:“结果A”
输入:“文本B” → 输出:“结果B”
❌ 混乱格式:
“文本A” → 结果A
输入: “文本B” => {“output”: “结果B”}
技巧:使用代码块或固定模板包裹示例,强化结构感知。
4. 简洁性与去噪:剔除无关信息
示例应只保留完成任务所需的最小上下文,避免冗余细节干扰模型注意力。
例如,在命名实体识别中:
- ✅ 精简:“张三在北京工作。” → [人名: 张三, 地点: 北京]
- ❌ 冗余:“昨天,我朋友张三(他今年30岁)在北京的一家科技公司开始新工作。” → …(过多修饰分散焦点)
二、高级选择策略
1. 基于相似度检索动态选择示例(Retrieval-Augmented Few-shot)
不使用固定示例,而是根据当前输入,从示例库中检索最相似的 K 个样本作为上下文。这能显著提升对新输入的适配性。
实现步骤:
- 将所有候选示例编码为向量(使用 embedding 模型);
- 计算当前输入与各示例的语义相似度;
- 选取 Top-K 最相似示例插入 Prompt。
适用于:开放域任务、输入变化大的场景(如客服问答、文档摘要)。
2. 难度分层:由简到繁排列
将示例按复杂度递增排序,帮助模型逐步建立认知:
- 简单明确案例(如标准格式);
- 含轻微噪声案例(如错别字、口语化);
- 边界或歧义案例(如多义词、隐含逻辑)。
心理学依据:符合人类“脚手架学习”(Scaffolding)原理。
3. 对抗性示例增强
主动加入易混淆样本,显式区分相似类别,防止模型过度泛化。
示例:意图识别
“我想订机票” → book_flight
“你们怎么订票?” → ask_process(非订票!)
此类示例能有效抑制模型将“提及”误判为“执行”。
4. 平衡类别分布
在分类任务中,确保各类别示例数量均衡,避免模型偏向高频类别。
若实际数据中“positive”占 90%,但在 few-shot 中仍应提供等量的 positive/negative/neutral 示例,以校正先验偏差。
三、实战设计模板
模板结构建议:
你是一个[角色]。请完成以下任务:

[清晰任务描述]

示例:
---
输入:“{example1_input}”
输出:“{example1_output}”
---
输入:“{example2_input}”
输出:“{example2_output}”
---

现在,请处理以下输入:
“{new_input}”
关键要素:
- 角色设定 + 任务说明(激活领域知识);
- 分隔符
---明确划分示例边界; - 输入/输出字段显式标注;
- 新输入单独列出,避免混淆。
四、常见陷阱与规避方法
| 陷阱 | 风险 | 解决方案 |
|---|---|---|
| 示例过少(<2) | 模式不稳固 | 至少提供 2~3 个高质量示例 |
| 示例过于相似 | 泛化能力差 | 主动引入多样性与边界 case |
| 包含错误示例 | 模型学错 | 严格验证每个示例的正确性 |
| 忽略输出格式 | 返回自由文本 | 在示例和指令中双重强调格式 |
| Token 超限 | 截断关键信息 | 优先保留高信息量示例,压缩冗余 |
五、评估与迭代
Few-shot 效果需通过以下方式验证:
- 人工抽样检查:观察模型在不同输入下的表现一致性;
- 自动化测试集:构建包含典型 case 的 benchmark,计算准确率;
- A/B 测试:对比不同示例组合的业务指标(如客服解决率);
- 错误分析:收集失败案例,反向优化示例设计。
黄金法则:Few-shot 不是一次性配置,而是一个持续迭代的优化过程。
总结
优秀的 Few-shot 示例 = 精准任务对齐 + 多样性覆盖 + 格式严格统一 + 边界情况显式处理。通过结合动态检索、难度分层和对抗增强等策略,可将少样本提示从“经验尝试”升级为“系统工程”。在资源允许时,甚至可训练小型模型自动筛选最优示例集,实现提示的智能化优化。