在大模型应用开发的江湖里,LangChain 和 LlamaIndex 无疑是两座绕不开的高峰。很多刚入局的开发者往往会陷入“二选一”的纠结:到底该用谁来搭建我的 AI 应用?其实,这两个框架并非非此即彼的竞争关系,它们更像是“左脑”与“右脑”的分工——一个擅长逻辑编排与决策,一个擅长数据索引与检索。
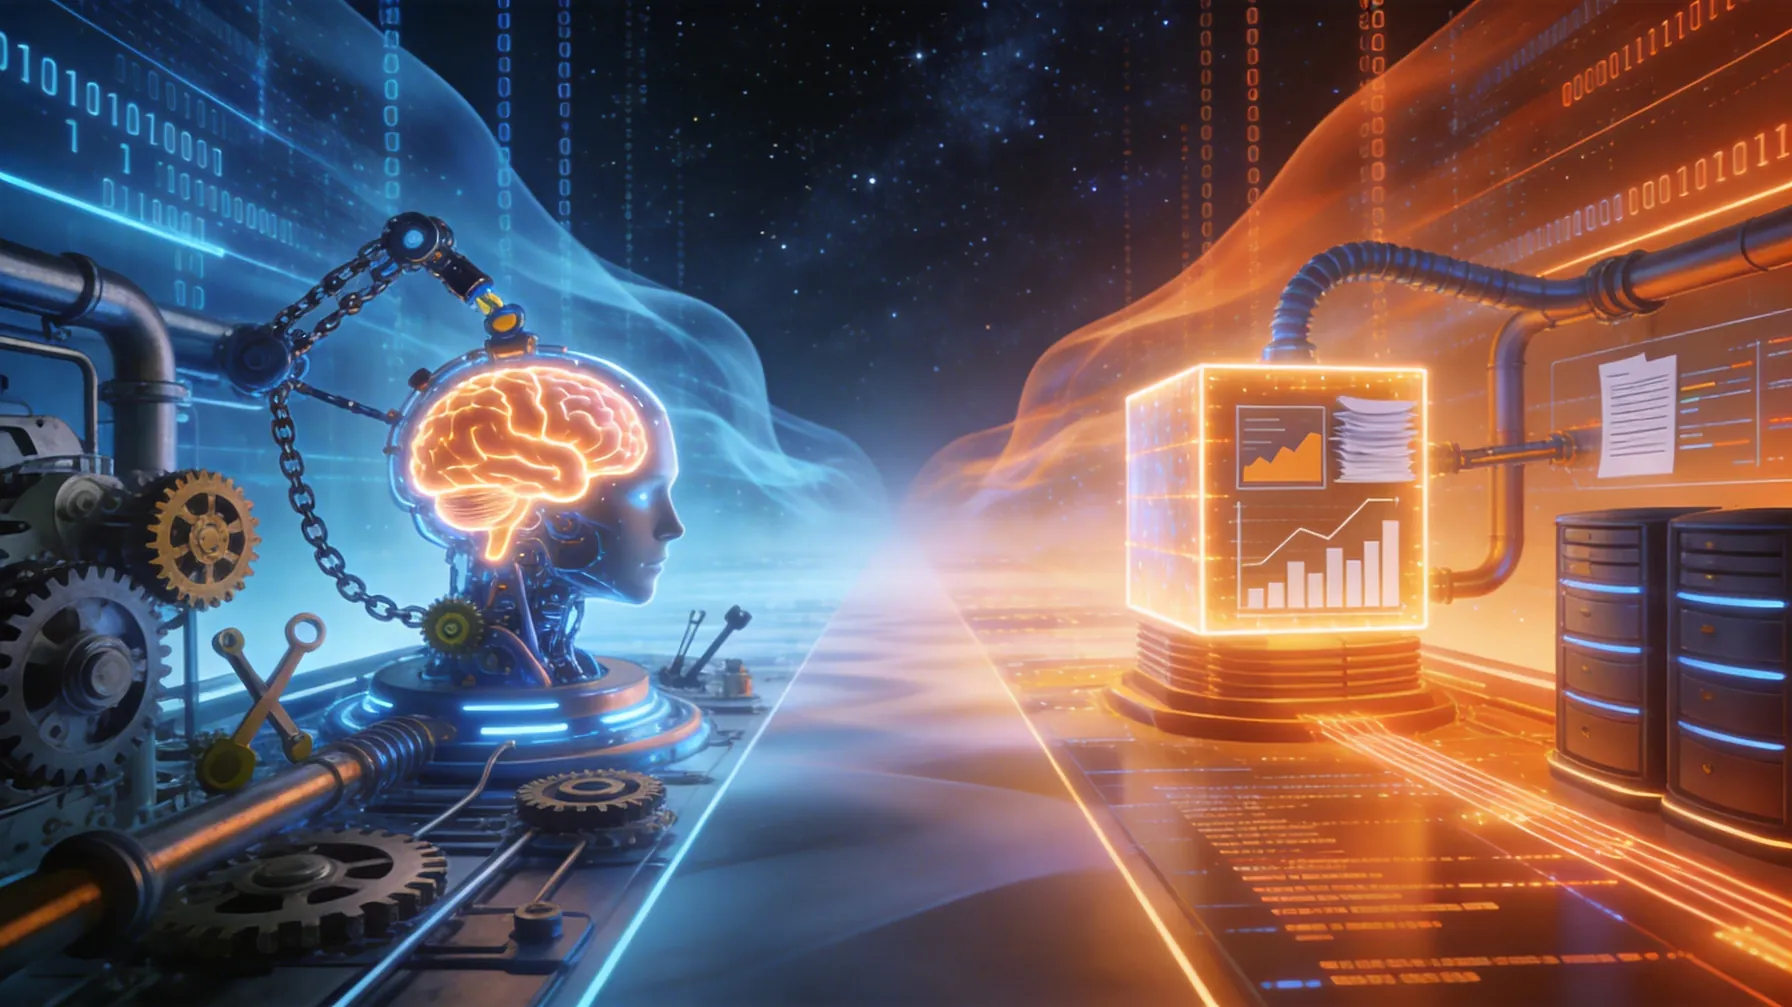
要真正用好这两个工具,我们需要跳出代码细节,从架构定位和设计哲学的层面去理解它们的本质区别。LangChain 更像是一个通用的操作系统,致力于解决大模型与万物(工具、API、记忆)的连接与编排;而 LlamaIndex 则像是一个专业的数据管道,专注于解决大模型如何高效“吃进”私有数据并精准“吐出”答案的问题。
核心定位:流程编排 vs 数据索引
LangChain 的核心关键词是**“编排”。它的设计初衷是让大模型具备“手脚”和“记忆”。在 LangChain 的世界里,大模型是一个大脑,它需要通过 Chain(链)来串联各种动作,或者通过 Agent(智能体)来自主决定调用哪些工具。它关注的是任务流**——即如何把一个大任务拆解成多个步骤,并协调不同的组件去完成。
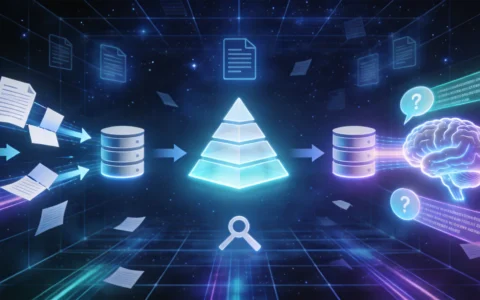
LlamaIndex 的核心关键词则是**“数据”。它的前身叫 GPT Index,名字就暴露了它的基因。它专注于解决大模型“幻觉”和“知识滞后”的问题,通过 RAG(检索增强生成)技术,将企业内部的私有数据(如 PDF、数据库、Notion 文档)转化为大模型可理解的向量索引。它关注的是数据流**——即如何把非结构化数据清洗、切分、索引,并在用户提问时,以最快速度找到最相关的上下文。
如果把构建 AI 应用比作开一家餐厅,LangChain 是餐厅的经理和服务员,负责接待客人、理解需求、协调后厨做菜、上菜以及处理各种突发状况;而LlamaIndex 则是食材仓库管理员,负责把各种食材(数据)分类存储、保鲜,并在厨师(大模型)需要时,瞬间提供最新鲜的原料。
功能特性的深度对比
虽然两者都能实现 RAG 应用,但在具体实现路径和功能侧重上,差异非常明显。
LangChain 的强项在于“连接”与“灵活”。 它拥有极其丰富的集成生态,几乎支持市面上所有的主流大模型、向量数据库和第三方 API。它的 Agent 模块非常强大,支持 ReAct 等多种推理模式,能让模型根据用户意图动态选择工具。例如,用户问“帮我查下北京天气并给女友发个邮件”,LangChain 可以编排“天气查询工具”和“邮件发送工具”按顺序执行。此外,LangChain 的 Memory 模块能很好地管理多轮对话的历史记录,让应用具备长期记忆。
LlamaIndex 的强项在于“检索”与“效率”。 它在数据加载器(Data Loaders)和索引策略上做到了极致。它支持极其复杂的数据结构,如知识图谱索引、树形索引等,这对于处理超长文档或复杂关联数据非常有效。在检索阶段,LlamaIndex 提供了高级的检索策略,如混合检索(关键词+向量)、重排序(Re-ranking)等,能显著提升回答的准确率。它的查询引擎(Query Engine)专为“问答”优化,开箱即用,配置简单。
| 维度 | LangChain | LlamaIndex |
|---|---|---|
| 核心使命 | 应用编排与智能体构建 | 数据连接与检索增强 |
| 擅长领域 | 复杂工作流、多工具调用、对话管理 | 知识库问答、语义检索、非结构化数据处理 |
| 上手难度 | 较高,概念多(Chain/Agent/Prompt) | 较低,专注于数据接入和查询 |
| 生态广度 | 极广,几乎覆盖所有 AI 相关服务 | 较深,专注于数据源和存储后端 |
场景化选型指南:到底该选谁?
理解了定位差异,选型就变得清晰了。
如果你要开发一个“智能助理”或“自动化工作流”,请毫不犹豫选择 LangChain。
比如,你需要做一个能够自动分析财报、调用计算器算出增长率、然后生成投资报告的机器人;或者做一个能理解用户意图、自主决定是搜索谷歌还是查询内部数据库的客服系统。这些场景涉及复杂的逻辑判断和多步骤的工具协同,正是 LangChain 的 Agent 大显身手的地方。LangChain 允许你像搭积木一样,自由定义任务的执行路径。
如果你要开发一个“企业知识库”或“文档问答系统”,LlamaIndex 是更优解。
比如,公司有几千份产品手册、技术文档和政策文件,员工需要随时查询。这种场景的核心痛点是“如何从海量文档中精准找到答案”。LlamaIndex 提供了现成的数据加载、切分和索引方案,你只需要几行代码就能搭建一个高性能的问答引擎。它对长文本的处理和元数据过滤的支持,比 LangChain 的原生实现更加细腻和高效。
当然,成年人的世界往往不做选择题。
在复杂的企业级应用中,“LangChain + LlamaIndex”的混合架构才是最完美的方案。你可以用 LlamaIndex 作为数据后端,负责高效地处理和检索私有数据;然后用 LangChain 作为应用前端,负责处理用户交互、意图识别和流程控制。在这种架构下,LlamaIndex 甚至可以作为 LangChain 的一个“工具”被调用——当 Agent 判断用户需要查询知识库时,就调用 LlamaIndex 的检索引擎,获取信息后再进行后续处理。这种强强联合,既发挥了 LlamaIndex 在数据处理上的专业性,又利用了 LangChain 在流程编排上的灵活性。