在 LangChain 构建的 RAG(检索增强生成)应用体系中,**DocumentLoader(文档加载器)**扮演着“守门员”的关键角色。如果把大模型应用比作一场烹饪,那么 DocumentLoader 就是负责买菜、洗菜和切菜的环节。无论你的模型多么强大,如果输入的数据格式混乱、包含大量噪点或者根本无法读取,最终生成的答案也必然是糟糕的(Garbage In, Garbage Out)。LangChain 提供了超过 80 种文档加载器,覆盖了从本地文件到云端数据库的各种数据源,理解这些加载器的分类与特性,是构建高质量 AI 应用的第一步。
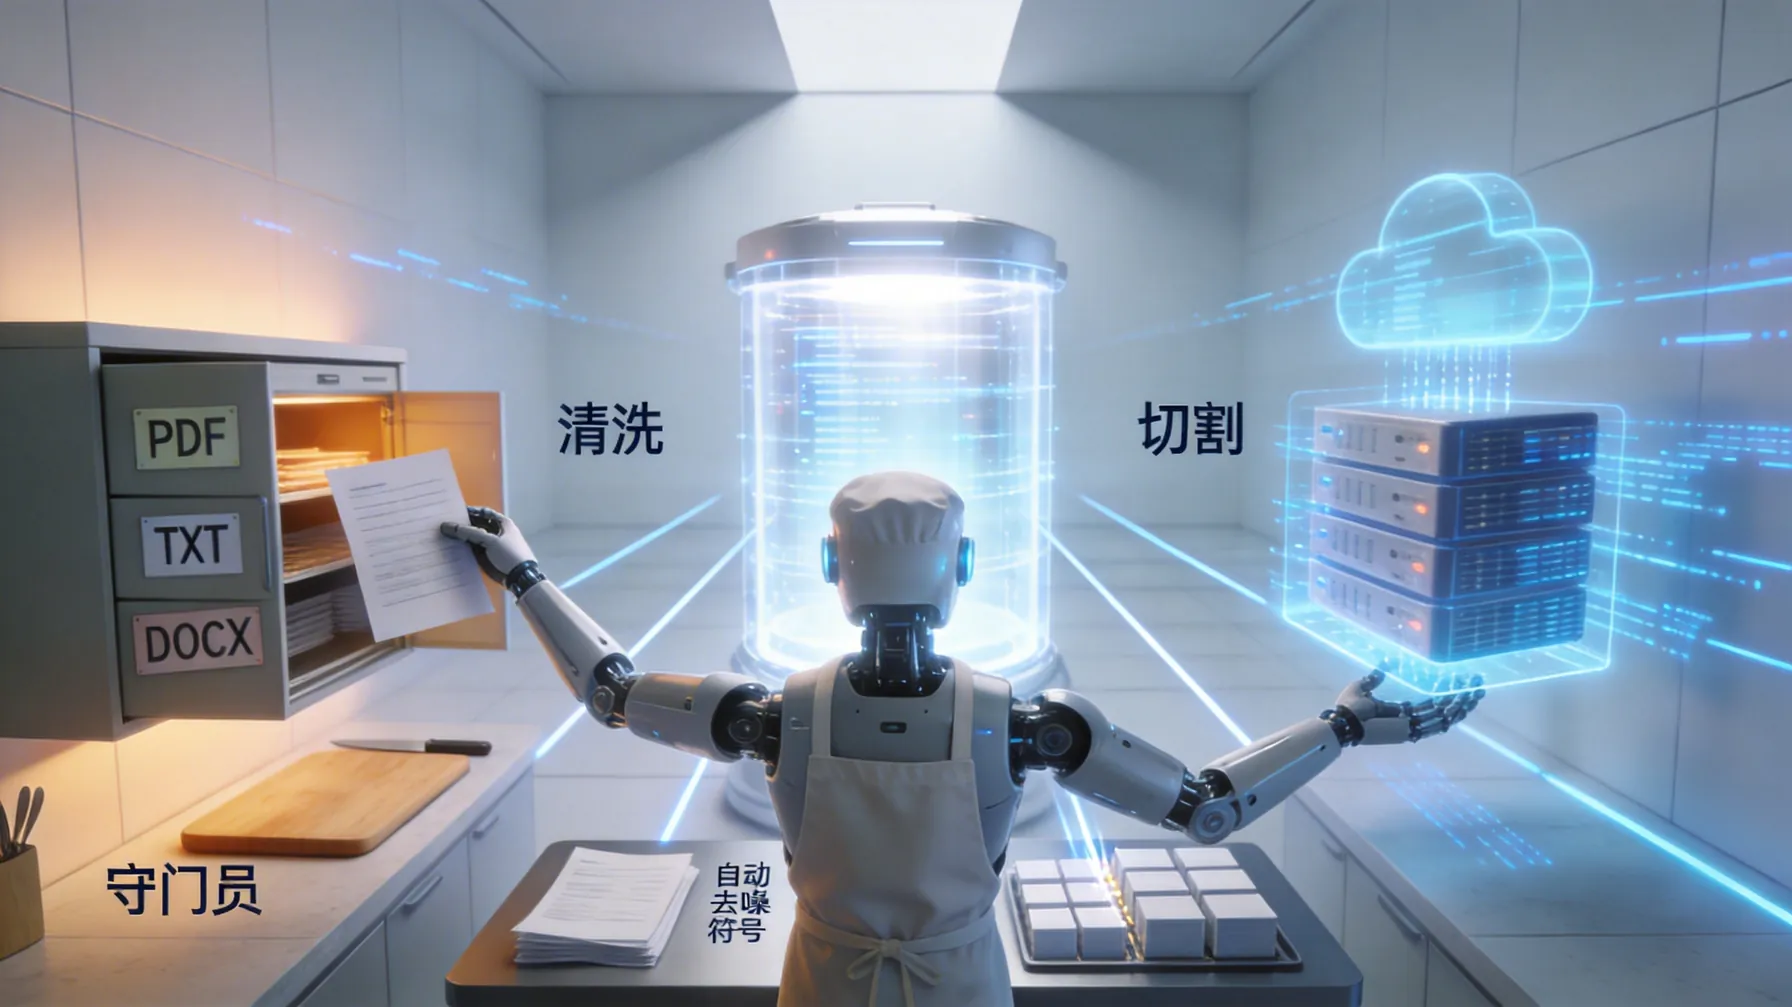
DocumentLoader 的核心分类体系
LangChain 的文档加载器虽然繁多,但根据数据源的性质和存储位置,我们可以将其清晰地划分为三大核心阵营。
1. 本地文件与非结构化数据加载器
这是最基础也是最常用的类别,主要用于处理存储在本地文件系统或通用协议中的非结构化数据。
- PDF 加载器:如
PyPDFLoader和PDFPlumberLoader。PDF 是企业和学术场景中最常见的格式,但处理起来也最棘手,因为涉及复杂的排版、页眉页脚和多栏布局。 - 文本与代码加载器:如
TextLoader。这是最基础的加载器,用于处理.txt、.py、.md等纯文本文件。它通常支持编码格式的自动检测,是处理简单数据的首选。 - 办公文档加载器:如
UnstructuredWordDocumentLoader和UnstructuredPowerPointLoader。这类加载器通常依赖unstructured库,能够解析.docx和.pptx中的文本、表格甚至元数据。 - 网页加载器:如
WebBaseLoader。它利用BeautifulSoup等库抓取网页 HTML 并提取文本内容,是构建互联网知识库的基础。
2. 结构化数据加载器
虽然大模型擅长处理非结构化文本,但企业数据往往存储在表格中。这类加载器专门用于“翻译”结构化数据。
- CSV 与 Excel 加载器:如
CSVLoader和UnstructuredExcelLoader。它们不仅仅是读取文件,还能将每一行数据转换为一个独立的Document对象,或者将整张表转换为自然语言描述,以便 LLM 理解。 - 数据库加载器:如
SQLDatabaseLoader。它允许 LLM 通过 SQL 查询与关系型数据库交互,将查询结果转化为文档上下文。
3. 专有平台与云存储加载器
随着 SaaS 应用的普及,数据往往散落在 Notion、Google Drive 或 AWS S3 中。这类加载器通过 API 直接对接这些服务。
- SaaS 集成加载器:如
NotionDirectoryLoader、SlackDirectoryLoader。它们通过调用平台的 API,将聊天记录、笔记页面拉取并转化为标准文档。 - 云存储加载器:如
S3FileLoader或AzureBlobStorageLoader。它们解决了云端海量文件的批量读取问题,通常支持流式读取以节省内存。
主流加载器实战与选型策略
面对琳琅满目的加载器,如何选择最适合当前场景的那一个?这不仅取决于文件格式,更取决于你对数据精度和处理效率的权衡。
PDF 处理:速度与质量的博弈
在处理 PDF 时,PyPDFLoader 是最常用的选择,它速度快且依赖少,适合处理纯文本型的 PDF。然而,如果遇到扫描版 PDF 或排版复杂的文档(如双栏论文),PyPDFLoader 往往会丢失格式或乱码。此时,应选择基于 OCR 技术或布局分析更强的加载器,如 PDFPlumberLoader 或集成了 unstructured 的加载器。虽然它们处理速度稍慢,但能精准识别表格和段落结构,显著提升后续检索的准确率。
代码与 Markdown:保留结构的重要性
如果你是构建一个“代码助手”,直接使用 TextLoader 可能会破坏代码的缩进或 Markdown 的层级。在这种情况下,建议使用支持结构化解析的加载器,或者在加载时保留元数据(如文件路径、语言类型)。例如,UnstructuredMarkdownLoader 可以设置 mode="elements",将标题、列表项、代码块分别解析为不同的元素,这对于后续的分块(Splitting)策略至关重要。
表格数据:行级与列级的取舍
对于 CSV 文件,CSVLoader 默认会将每一行作为一个文档,并将所有列的内容拼接在一起。这在数据量较小且列数较少时很有效。但如果表格非常宽(列很多),直接拼接会导致 Token 爆炸且语义模糊。此时,更高级的策略是自定义加载逻辑,或者使用 DataFrameLoader 将数据转为 Pandas DataFrame 后再进行特定的文本化处理。
高级技巧:自定义与懒加载
除了使用现成的加载器,LangChain 还赋予了开发者极高的自由度来应对特殊场景。
自定义加载器
当现有的加载器无法满足需求时(例如需要解析某种特殊的二进制日志文件),你可以继承 BaseLoader 类来实现自己的加载器。核心是重写 lazy_load 方法,通过生成器(Generator)逐行或逐块 yield 文档对象。这种方式不仅灵活,而且符合 Python 的迭代器协议,非常适合处理超大文件。
懒加载与内存优化
在处理 GB 级别的大文件或数万个文档的目录时,一次性调用 load() 方法可能会导致内存溢出(OOM)。LangChain 的大多数加载器都支持 lazy_load()。这是一个异步或生成器接口,它允许你流式地处理文档——读一个、处理一个、入库一个,而不是一次性将所有数据加载到内存中。在生产环境中,务必优先使用 lazy_load 或 DirectoryLoader 的流式接口来保障系统的稳定性。
目录加载器的批量处理
对于本地文件夹中的混合文件(如同时包含 PDF 和 TXT),DirectoryLoader 是神器。它支持通配符(glob)匹配,并允许通过 loader_cls 参数为不同后缀的文件指定不同的加载器。例如,你可以配置它用 PyPDFLoader 处理 .pdf,用 TextLoader 处理 .txt,从而实现一键加载整个项目目录。
选择合适的 DocumentLoader 不仅仅是技术问题,更是对数据特性的深刻理解。只有选对了“入口”,才能确保后续的 Embedding 和检索环节高效运转,最终让大模型发挥出真正的智能。