在 LangChain 的开发实战中,很多初学者都会遇到一个令人抓狂的“鬼故事”:你千叮咛万嘱咐让大模型返回一个 JSON 格式的数据,结果它偏偏要给你加上一句“好的,这是你要的 JSON:”或者在 JSON 后面补上一句“希望这对你有帮助”。对于人类来说,这完全没问题;但对于需要对接后端业务系统的代码来说,这多出来的几个字符就是致命的格式错误,直接导致 json.loads() 报错,整个程序崩溃。
这就是 OutputParser(输出解析器) 存在的意义。它就像是 LangChain 流水线上的“质检员”和“格式化专家”。它的核心作用不仅仅是提取文本,更是为了将大模型那自由奔放、非结构化的自然语言输出,强制转换为程序可以直接处理的结构化数据(如 JSON、Python 对象、列表等)。在构建生产级应用时,OutputParser 是确保数据链路稳定、实现“模型与代码无缝对接”的关键组件。
OutputParser 的核心作用:从“聊天”到“办事”
大语言模型(LLM)本质上是基于概率预测下一个字符的文本生成器,它的原生输出是“非结构化文本”。而我们的业务系统(如数据库、API、前端界面)需要的是“结构化数据”。OutputParser 在这两者之间架起了一座桥梁,主要承担三大职责:
- 指令注入(格式引导)
这是 OutputParser 最容易被忽视但最重要的功能。每个解析器都有一个get_format_instructions()方法。在构建 Prompt 时,我们需要把这个方法生成的“格式指令”塞进提示词里。这相当于在任务开始前,先给大模型立好规矩:“别废话,只准按这个格式输出”。例如,它会告诉模型:“你的输出必须是一个合法的 JSON,包含 name 和 age 字段”。 - 数据清洗与转换
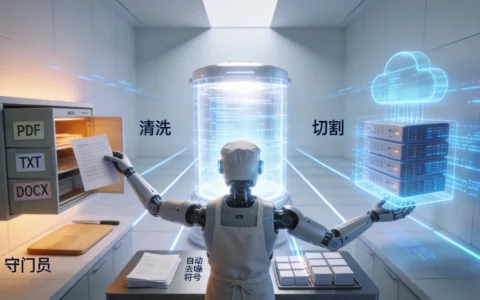
大模型有时候很“话痨”,喜欢在输出前后加一些礼貌用语或 Markdown 标记(如 “`json)。OutputParser 会自动识别并剔除这些冗余信息,只保留核心数据,并将其转换为 Python 的原生类型(字典、列表、字符串等)。 - 数据校验
高级的解析器(如 PydanticOutputParser)不仅能转换数据,还能校验数据的类型。如果模型强行输出了错误的类型(比如把年龄输出了字符串 “twenty” 而不是数字 20),解析器可以抛出异常,甚至触发自动重试机制,强迫模型修正错误。
常见 OutputParser 类型详解
LangChain 提供了丰富的解析器来应对不同的场景,我们可以根据对数据结构化程度的要求,将它们分为三个梯队。
第一梯队:基础文本处理
当你只需要大模型做简单的文本生成,或者只需要提取简单的列表时,这些轻量级工具就足够了。
- StrOutputParser
- 作用:这是最基础的解析器,通常作为默认选项。它的作用仅仅是从
AIMessage对象中提取出纯文本内容(content 字段)。 - 场景:普通的对话机器人、文章摘要生成、创意写作。它不对格式做任何约束,原样返回字符串。
- 作用:这是最基础的解析器,通常作为默认选项。它的作用仅仅是从
- CommaSeparatedListOutputParser
- 作用:专门用于提取逗号分隔的列表。它会指示模型输出如 “苹果, 香蕉, 橘子” 这样的格式,并自动将其解析为 Python 的
['苹果', '香蕉', '橘子']列表。 - 场景:关键词提取、标签生成、简单的选项罗列。
- 作用:专门用于提取逗号分隔的列表。它会指示模型输出如 “苹果, 香蕉, 橘子” 这样的格式,并自动将其解析为 Python 的
- EnumOutputParser
- 作用:限制模型的输出范围。你需要预定义一个枚举类(如颜色:红、绿、蓝),解析器会强制模型只能从这几个选项中选一个输出。
- 场景:情感分析(正面/负面)、分类任务、状态标记。
第二梯队:通用结构化数据
当业务需要复杂的键值对数据时,我们需要更强大的工具。
- JsonOutputParser
- 作用:这是最常用的结构化解析器。它会生成一段详细的 JSON Schema 指令,要求模型输出合法的 JSON。它会自动处理模型输出中常见的 Markdown 代码块标记(“`),直接返回 Python 字典。
- 场景:提取实体信息(如从简历中提取姓名、电话)、生成 API 响应数据、复杂的配置生成。
- StructuredOutputParser
- 作用:这是
JsonOutputParser的前身(在某些旧版本中常用),它允许你通过ResponseSchema定义字段名和描述。虽然功能与 JSON 解析器类似,但它更侧重于通过自然语言描述字段含义来引导模型。
- 作用:这是
第三梯队:强类型与对象映射(生产级推荐)
在企业级开发中,我们通常推荐使用 Pydantic 相关的解析器,因为它们提供了最强的类型安全和校验能力。
- PydanticOutputParser
- 作用:这是目前最强大的解析器之一。它允许你定义一个继承自
BaseModel的 Python 类。解析器会根据这个类的字段类型(int, str, List, etc.)生成指令,并在模型输出后,尝试将结果实例化为这个 Python 对象。 - 优势:
- 强类型校验:如果模型输出的数据类型不对(例如字段要求是 int,模型给了 string),Pydantic 会直接报错,防止脏数据进入业务逻辑。
- IDE 智能提示:解析后的结果是一个真正的 Python 对象,你在写代码时可以获得完整的属性提示,而不是去猜字典的 key 是什么。
- 场景:复杂的数据抽取、需要严格校验的业务流程、将 LLM 输出直接存入数据库。
- 作用:这是目前最强大的解析器之一。它允许你定义一个继承自
选型决策指南
为了帮助你在实战中快速选择,我们可以根据需求场景整理一份决策表:
| 需求场景 | 推荐解析器 | 输出格式示例 | 优势 |
|---|---|---|---|
| 闲聊/写作 | StrOutputParser |
“这是一段优美的散文…” | 简单直接,无格式约束 |
| 关键词/标签 | CommaSeparatedListOutputParser |
['AI', 'Tech', 'News'] |
快速提取列表,无需处理 JSON |
| 分类/状态判断 | EnumOutputParser |
Sentiment.POSITIVE |
严格限制输出范围,防止幻觉 |
| 通用数据提取 | JsonOutputParser |
{"name": "Alice", "age": 30} |
兼容性好,适合前后端交互 |
| 复杂业务/强校验 | PydanticOutputParser |
Person(name="Alice", age=30) |
类型安全,代码健壮性最高 |
实战中的“黄金法则”
在使用 OutputParser 时,有一个必须遵守的流程规范,否则解析器将无法工作:
必须注入格式指令!
很多开发者实例化了 PydanticOutputParser 后直接丢给模型,结果发现模型依然我行我素。这是因为模型并不知道你要解析成什么格式。正确的做法是调用解析器的 get_format_instructions() 方法,并将返回的字符串放入你的 Prompt 模板中。
标准代码模式:
# 1. 定义解析器
parser = PydanticOutputParser(pydantic_object=Person)

# 2. 获取格式指令
format_instructions = parser.get_format_instructions()

# 3. 构建 Prompt,将指令塞进去
prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个数据提取专家。{format_instructions}"), # 这里注入指令
    ("human", "请从这段文本中提取人物信息:{text}")
])

# 4. 构建链并运行
chain = prompt | model | parser
result = chain.invoke({"text": "我叫张三,今年25岁", "format_instructions": format_instructions})
OutputParser 是将 LLM 从“玩具”变成“工具”的关键一环。通过合理使用这些解析器,特别是结合 Pydantic 的强类型能力,你可以构建出数据稳定、逻辑严密的 AI 应用,彻底告别正则表达式清洗数据的痛苦。