在实际的AI应用开发中,很少有项目能够仅依赖单一框架完成所有功能。开发者通常需要结合多个AI框架的优势,比如使用Hugging Face获取预训练模型,利用LlamaIndex处理复杂的文档检索,通过FastAPI构建Web服务,或者集成LangGraph实现状态管理。LangChain正是在这种多框架协作的需求背景下,设计了灵活的集成架构,使其成为连接不同AI工具的”胶水层”,让开发者能够自由组合最佳的技术栈来解决具体问题。
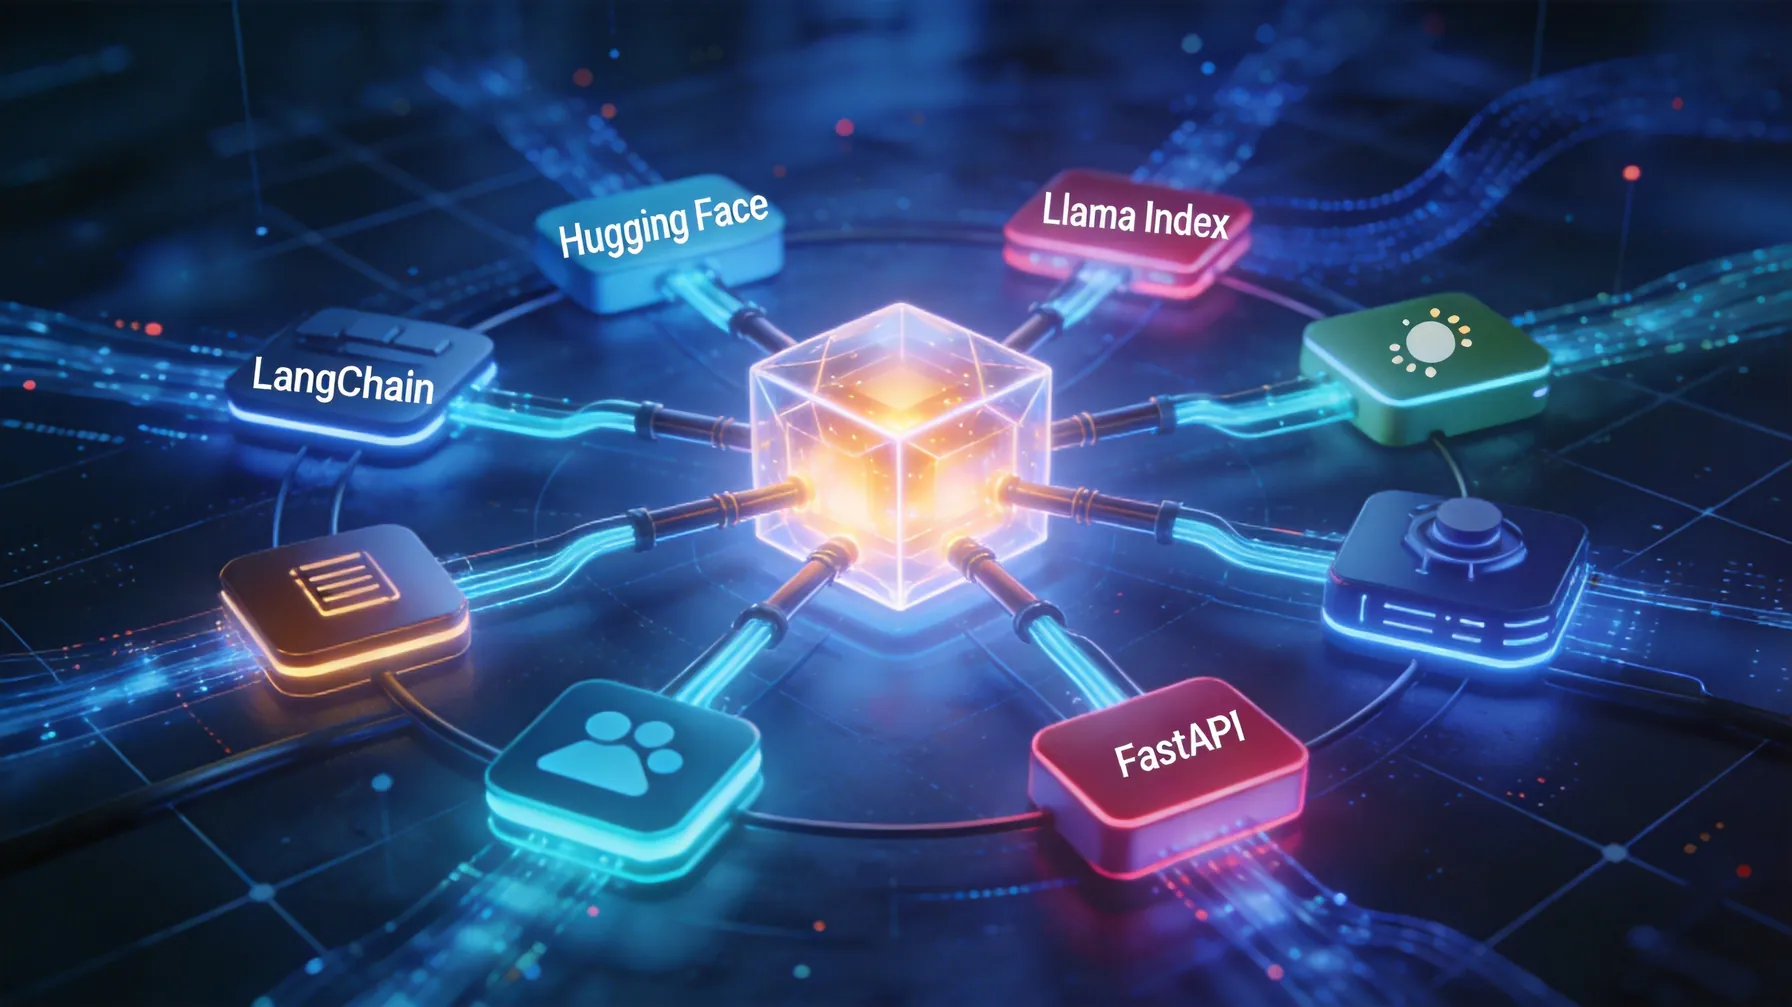
与主流大语言模型框架的深度集成
Hugging Face Transformers的无缝对接
Hugging Face作为开源AI模型的重要平台,提供了大量高质量的预训练模型。LangChain通过HuggingFacePipeline和HuggingFaceHub等组件,实现了与Hugging Face生态的深度集成。
from langchain_community.llms import HuggingFacePipeline
from transformers import AutoTokenizer, AutoModelForCausalLM, pipeline

# 本地Hugging Face模型集成
model_name = "meta-llama/Llama-2-7b-chat-hf"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)

hf_pipeline = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    max_length=1024
)

llm = HuggingFacePipeline(pipeline=hf_pipeline)

# 使用LangChain标准接口调用
response = llm.invoke("解释一下注意力机制的工作原理")
print(response)
这种集成方式的优势在于能够充分利用Hugging Face丰富的模型库,同时享受LangChain提供的统一接口和高级功能。开发者可以在不改变核心业务逻辑的情况下,轻松切换不同的底层模型,无论是开源的Llama系列、Falcon系列,还是自定义微调的模型。
LlamaIndex的协同工作模式
LlamaIndex专注于文档索引和检索优化,而LangChain擅长工作流编排和工具集成。两者的结合能够构建出功能强大的RAG(Retrieval-Augmented Generation)系统。
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
from langchain_community.embeddings import HuggingFaceEmbeddings
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI

# 使用LlamaIndex构建高效的文档索引
documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)

# 将LlamaIndex的查询引擎转换为LangChain工具
query_engine = index.as_query_engine()

def llama_index_tool(query: str) -> str:
    """将LlamaIndex查询引擎封装为LangChain工具"""
    response = query_engine.query(query)
    return str(response)

# 在LangChain工作流中使用LlamaIndex工具
prompt = ChatPromptTemplate.from_template(
    "基于以下上下文回答问题:{context}nn问题:{question}"
)

llm = ChatOpenAI()
rag_chain = (
    {"context": lambda x: llama_index_tool(x["question"]), "question": lambda x: x["question"]}
    | prompt
    | llm
)
这种协同模式充分发挥了两个框架的优势:LlamaIndex提供高效的向量检索和文档处理能力,LangChain提供灵活的工作流编排和工具调用机制。对于需要处理大量文档的企业知识库应用,这种组合方案能够显著提升检索准确性和响应速度。
与Web框架和API工具的集成
FastAPI/Flask服务化部署
将LangChain应用部署为Web服务是生产环境的常见需求。FastAPI和Flask等Web框架提供了简单的方式将LangChain链暴露为REST API。
from fastapi import FastAPI
from pydantic import BaseModel
from langchain_core.runnables import RunnableLambda

app = FastAPI()

class QueryRequest(BaseModel):
    question: str
    user_id: str = None

class QueryResponse(BaseModel):
    answer: str
    sources: list = []

# LangChain链定义
def process_query(inputs: dict) -> dict:
    # 复杂的LangChain处理逻辑
    context = retriever.invoke(inputs["question"])
    answer = qa_chain.invoke({"context": context, "question": inputs["question"]})
    return {"answer": answer, "sources": extract_sources(context)}

langchain_processor = RunnableLambda(process_query)

@app.post("/query", response_model=QueryResponse)
async def handle_query(request: QueryRequest):
    result = langchain_processor.invoke({
        "question": request.question,
        "user_id": request.user_id
    })
    return QueryResponse(**result)
这种集成方式使得LangChain应用能够轻松融入现有的微服务架构,支持负载均衡、自动扩缩容、监控告警等生产级特性。同时,FastAPI的异步支持也能够充分利用LangChain的异步执行能力,提高系统的并发处理能力。
与消息队列和事件驱动架构的结合
在高并发场景下,LangChain应用可以与消息队列(如Redis、Kafka、RabbitMQ)集成,实现异步处理和流量削峰。
import redis
import json
from celery import Celery

# Celery配置
celery_app = Celery('langchain_tasks', broker='redis://localhost:6379/0')

@celery_app.task
def process_langchain_query(task_data):
    """异步处理LangChain查询任务"""
    question = task_data['question']
    user_id = task_data['user_id']

    # 执行LangChain链
    result = langchain_chain.invoke({"question": question, "user_id": user_id})

    # 将结果存储到Redis,供前端轮询获取
    redis_client = redis.Redis()
    redis_client.setex(f"result:{task_data['task_id']}", 3600, json.dumps(result))

    return result

# Web API端点
@app.post("/async-query")
async def async_query(request: QueryRequest):
    task_id = str(uuid.uuid4())
    task_data = {
        "task_id": task_id,
        "question": request.question,
        "user_id": request.user_id
    }

    # 异步提交任务
    process_langchain_query.delay(task_data)

    return {"task_id": task_id, "status": "processing"}
这种架构模式特别适合处理耗时较长的复杂查询,避免阻塞Web服务器,提升整体系统的响应性能和稳定性。
与向量数据库和存储系统的集成
多种向量数据库的统一接口
LangChain支持与多种向量数据库集成,包括Pinecone、Weaviate、Chroma、FAISS、Milvus等。通过统一的VectorStore接口,开发者可以轻松切换不同的向量存储后端。
from langchain_pinecone import PineconeVectorStore
from langchain_chroma import Chroma
from langchain_openai import OpenAIEmbeddings

embeddings = OpenAIEmbeddings()

# Pinecone集成
pinecone_store = PineconeVectorStore(
    index_name="my-index",
    embedding=embeddings,
    pinecone_api_key="your-api-key"
)

# Chroma集成
chroma_store = Chroma(
    persist_directory="./chroma_db",
    embedding_function=embeddings
)

# 在运行时根据配置选择向量存储
def get_vector_store(config):
    if config["vector_db"] == "pinecone":
        return pinecone_store
    elif config["vector_db"] == "chroma":
        return chroma_store
    else:
        raise ValueError("Unsupported vector database")

# LangChain检索器
retriever = get_vector_store(config).as_retriever(search_kwargs={"k": 5})
这种抽象层设计使得应用能够在开发、测试、生产环境中使用不同的向量数据库,而无需修改核心业务逻辑。例如,在开发阶段使用轻量级的Chroma进行快速迭代,在生产环境中切换到高性能的Pinecone或Milvus。
与传统数据库的混合查询
在实际应用中,往往需要结合向量检索和传统数据库查询。LangChain可以通过自定义工具的方式集成SQL数据库、NoSQL数据库等传统存储系统。
from langchain.tools import tool
import sqlite3

@tool
def query_user_info(user_id: str) -> str:
    """查询用户基本信息"""
    conn = sqlite3.connect('users.db')
    cursor = conn.cursor()
    cursor.execute("SELECT name, email, role FROM users WHERE id = ?", (user_id,))
    result = cursor.fetchone()
    conn.close()

    if result:
        return f"用户信息:姓名={result[0]}, 邮箱={result[1]}, 角色={result[2]}"
    return "用户不存在"

@tool
def query_order_history(user_id: str, days: int = 30) -> str:
    """查询用户订单历史"""
    # 类似的数据库查询逻辑
    pass

# 将数据库查询工具集成到LangChain Agent中
tools = [query_user_info, query_order_history]
agent = create_openai_functions_agent(llm, tools, prompt)
agent_executor = AgentExecutor(agent=agent, tools=tools, verbose=True)
这种混合查询能力使得LangChain应用能够充分利用现有数据基础设施,实现结构化数据和非结构化数据的联合分析。
与监控和可观测性工具的集成
日志记录与性能监控
生产环境中的LangChain应用需要完善的监控和日志记录。通过集成OpenTelemetry、Prometheus等可观测性工具,可以实现端到端的性能监控。
from opentelemetry import trace
from langchain_core.callbacks import BaseCallbackHandler

class OpenTelemetryCallbackHandler(BaseCallbackHandler):
    def __init__(self):
        self.tracer = trace.get_tracer(__name__)

    def on_chain_start(self, serialized, inputs, **kwargs):
        self.span = self.tracer.start_span(f"chain.{serialized['name']}")
        self.span.set_attribute("inputs", str(inputs))

    def on_chain_end(self, outputs, **kwargs):
        self.span.set_attribute("outputs", str(outputs))
        self.span.end()

# 在LangChain链中添加监控回调
monitoring_handler = OpenTelemetryCallbackHandler()
result = langchain_chain.invoke(inputs, config={"callbacks": [monitoring_handler]})
错误追踪与告警集成
通过集成Sentry、Datadog等错误追踪工具,可以实时捕获和分析LangChain应用中的异常情况。
import sentry_sdk
from langchain_core.runnables import RunnableLambda

def error_handling_wrapper(func):
    """错误处理装饰器"""
    def wrapper(*args, **kwargs):
        try:
            return func(*args, **kwargs)
        except Exception as e:
            sentry_sdk.capture_exception(e)
            # 可以添加降级逻辑或默认响应
            raise e
    return wrapper

# 应用错误处理装饰器
safe_chain = RunnableLambda(error_handling_wrapper(process_query))
集成的最佳实践与注意事项
版本兼容性管理
不同AI框架的版本更新频繁,需要特别注意版本兼容性问题。建议使用虚拟环境和依赖锁定文件来管理不同框架的版本:
# requirements.txt 示例
langchain==0.1.16
langchain-community==0.0.34
transformers==4.38.0
llama-index==0.10.15
fastapi==0.109.0
性能优化策略
在多框架集成场景下,性能瓶颈可能出现在框架间的交互开销上。建议采用以下优化策略:
- 缓存机制:对重复的计算结果进行缓存,减少不必要的框架调用
- 批处理:将多个小请求合并为批量请求,提高处理效率
- 异步执行:充分利用各框架的异步能力,避免阻塞操作
- 资源池化:对数据库连接、模型实例等昂贵资源进行池化管理
安全性和权限控制
在集成外部服务时,需要特别注意安全性问题:
# 环境变量管理敏感信息
import os
from dotenv import load_dotenv

load_dotenv()

# 安全的API密钥管理
openai_api_key = os.getenv("OPENAI_API_KEY")
pinecone_api_key = os.getenv("PINECONE_API_KEY")

# 输入验证和清理
from pydantic import BaseModel, validator

class SecureQueryRequest(BaseModel):
    question: str

    @validator('question')
    def validate_question(cls, v):
        if len(v) > 1000:
            raise ValueError('问题长度不能超过1000字符')
        if any(keyword in v.lower() for keyword in ['drop ', 'delete ', 'script']):
            raise ValueError('包含不安全的内容')
        return v