AI 幻觉是指大模型在生成文本时输出”看似流畅自信、实际与事实或上下文不符”的内容——它并不是模型”撒谎”,而是其基于统计规律预测下一个 token 的训练目标内生出来的副产品。从数据噪声、训练奖励机制、Transformer 注意力稀释到解码阶段的随机采样,幻觉由四层链路共同放大;缓解手段因此也分四类:数据清洗与动态更新、训练目标重构、推理阶段的不确定性控制、以及检索增强生成(RAG)等外部知识锚定。理解这一因果链比记住某条 prompt 模板更关键。
一、AI 幻觉的两大权威分类
学术界对幻觉的划分已经收敛成两类,先分清类型再谈缓解会少走很多弯路。
- 事实性幻觉(Factuality Hallucination):模型生成的内容与可验证的客观事实冲突,例如错误地声称”蜂蜜可以帮助糖尿病患者稳定血糖”。
- 忠实性幻觉(Faithfulness Hallucination):输出与用户指令或提供的上下文不一致,例如用户问”糖尿病患者能否用蜂蜜代替糖”,模型只回答营养价值而未回应核心问题。
OpenAI 在 2025 年发表的论文《Why Language Models Hallucinate》把幻觉重新定义为一个”激励问题”——next-token 训练目标和排行榜奖励了自信的猜测,而非校准过的不确定性。这个视角改变了缓解策略的方向:从单纯”加更多数据”转向”重构奖励机制”。
二、四大成因与传导链路
幻觉不是单一原因,是四个层面缺陷逐级放大的结果。
| 层面 | 缺陷 | 典型表现 |
|---|---|---|
| 数据 | 知识长尾、错误信息、时效滞后 | 冷门概念被”统计性脑补” |
| 训练 | 二元评分鼓励猜测,过程监督缺失 | 模型宁编细节也不说”不知道” |
| 架构 | Transformer 注意力稀释、上下文窗口有限 | 长程逻辑断裂,跨域问题被”创造性补全” |
| 推理 | 局部注意力优先生成高频词、错误累积 | 首 token 错判引发”逻辑雪崩” |
四层缺陷沿着”概率生成”的本质逐级放大:错误素材 → 鼓励猜测 → 削弱逻辑约束 → 放大错误传导。在医疗、法律等关键领域,这种链式放大带来的风险会被显著放大。
三、缓解方案的五个层次
2025 年的工程实践表明,没有任何单一方法能完全消除幻觉——必须把多类手段叠加。常见组合分五层:
- 数据层:去重去脏、动态联网更新。DeepSeek V3 通过联网搜索把通用场景幻觉率从 29.67% 压到 24.67%。
- 训练目标层:把二元评分改成三元(答对加分、答错倒扣、拒答不扣分)。Google DeepMind 把错误损失权重提高 1.5 倍,幻觉率下降约 30%。
- 架构层:混合注意力机制(如 Gemini 2.5 Pro 的 Transformer + PathFormer)、过程监督(OpenAI 用 80 万条人类标注步骤数据做 step-level reward)。
- 推理层:SELF-FAMILIARITY 等零资源预检测、语义熵检测(多次生成后比较语义一致性)、明确拒答机制。
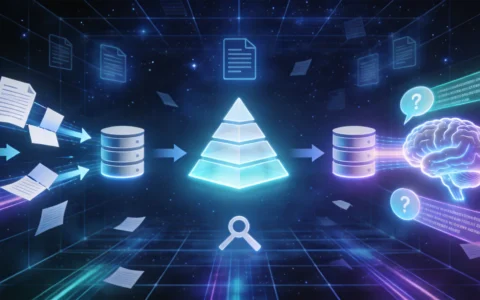
- 外部知识层:RAG 把模型回答锚定在检索到的文档上;Claude 在法律场景的”引用+验证”机制把忠实性幻觉率控制在 2% 以下。
下面给出一段用 RAG 思路降低幻觉的最小化伪代码,体现”先检索、再回答、强制引用”的链路:
# RAG 风格:先检索再回答,强制引用以减少幻觉
def rag_answer(question: str, retriever, llm) -> str:
    docs = retriever.search(question, top_k=5)        # 1. 从可信知识库检索
    context = "\n".join([f"[{i}] {d.text}" for i, d in enumerate(docs)])

    prompt = f"""仅根据以下文档回答用户问题;
    若文档未覆盖,请回答"无法确认"。

    文档:
    {context}

    问题:{question}
    请在每个关键事实后用 [n] 标注来源编号。"""

    answer = llm.generate(prompt)
    if not has_valid_citations(answer, docs):
        return "无法确认"
    return answer
这段代码前后有两个细节值得注意:前向要先做检索质量评估(chunk 大小、metadata 标签),否则”喂给模型的文档本身就是错的”,RAG 反而成了幻觉放大器;后向要校验引用——很多 RAG 系统的崩溃方式不是答错,而是编造一条引用编号,需要专门一层守门员。
四、典型案例:法律与搜索锚定
Anthropic Claude 在法律文书场景构建了”引用—验证”双循环:处理判例时先提取权威引文、生成回答时强制标注来源编号、检索不到出处时自动改为”基于现有信息无法确认”。这条规则直接解决了美国律师用 ChatGPT 提交 6 个虚构判例干扰司法的痛点。Google Gemini 走的是另一条路——其 google_search_retrieval 工具在遇到时效性问题时自动调用搜索,把通用场景幻觉率压到 0.7%。
五、检测与评估体系
缓解和检测必须配合使用。当前主流方案分三层:
- 基准测试:通用场景 TruthfulQA、医疗 Med-HALT、长文本与知识缺口 Concept7。
- 工具评估:MiniCheck 用 770M 参数模型做到接近 GPT-4 水平、成本低 400 倍;FENCE 提供声明级事实性判断。
- 人工验证:双模型交叉验证,例如 DeepSeek V3 在事实性测试中把幻觉率从 29.67% 压到 22.33%。
| 模型 | 通用场景幻觉率 | 事实性测试幻觉率 |
|---|---|---|
| Google Gemini 2.0 Flash | 0.7% | — |
| GPT-4o | 1.5% | — |
| GLM-4-9B | 1.3% | — |
| DeepSeek V3 | 2% | 29.67% |
| DeepSeek R1 | 3% | 22.33% |
表中数据说明:通用对话与专业事实查询之间存在”幻觉率鸿沟”,评估必须分场景,混在一起平均会掩盖真实风险。
六、落地时的三个易错点
- RAG 并非银弹:检索不到时模型会”自由发挥”,仍要配拒答机制。
- 温度参数过低反而有害:让模型在所有 token 上高置信输出,连”我不确定”都不会说。
- 过程监督成本高:OpenAI 那 80 万条步骤标注是 2025 年公开的最大规模之一,多数团队只能借助 CMU FENCE 这类自动化评估器做部分替代。
到这里,”先分清幻觉类型 → 找到成因层 → 选缓解层 → 上评估闭环”的完整链路就建立了。把它当成一个工程问题而不是”模型缺陷”,是 2025 年最务实的应对思路。
常见问题(FAQ)
Q1:AI 幻觉是 bug 吗?
不是 bug,是 next-token 训练目标的内在副产品,需要系统化缓解而非期待一次性修复。
Q2:RAG 能完全消除幻觉吗?
不能。检索质量差或模型忽略上下文时,RAG 系统仍会幻觉,必须叠加拒答与引用校验。
Q3:哪些场景绝对不能容忍幻觉?
医疗诊断、法律判例引用、金融风控等高风险场景,必须人工复核兜底,禁止模型直接面向终端用户。