把”先想后答”做成可切换的推理档位,比一味堆大模型更划算。深度思考(Deep Thinking)让模型在输出最终答案前先生成内部推理链,擅长数学、代码、规划等多步任务;自适应思考(Adaptive Thinking)则把”想多少”做成一档可调的旋钮,简单问题快答、复杂问题慢想。在 AI 编程助手项目里,团队最初统一调高思考档,结果成本翻倍、回答反而变啰嗦;后来改成”先尝试简单路径,复杂任务才升级”,同样的任务集总开销降下来,复杂用例的通过率反而稳住了。
一、两种思考模式的核心差异
深度思考源自 OpenAI o1 系列在 2024 年下半年带火的”内部思维链”做法:模型在回答用户前先在隐藏空间里做大量自检、试错、规划,最后才吐出一段精炼结论。自适应思考则是 Anthropic 在 2025 年初给 Claude 3.7 Sonnet 引入的”混合推理”思路——同一个模型既能秒回简单问题,也能按需进入深度模式,把推理当作可分配的计算预算来管理。
| 维度 | 深度思考(Deep Thinking) | 自适应思考(Adaptive Thinking) |
|---|---|---|
| 触发方式 | 默认开启或显式参数 | 推理档位(thinkingeffort、budgettokens)按需提升 |
| 思考过程可见性 | 通常隐藏(OpenAI o1 不暴露推理 token) | 可由用户控制预算,部分模型返回 thinking 块 |
| 适用任务 | 数学证明、复杂代码、博士级科学问题 | 多档位任务流,含简单查询与复杂编程混合 |
| 代表模型 | OpenAI o1、o3,DeepSeek-R1 | Claude 3.7/4 Sonnet(Extended Thinking),Gemini 2.5 Pro(thinking) |
| 成本/延迟特征 | 单次推理长、token 多 | 简单档与深度档差价大,按调用规模差异明显 |
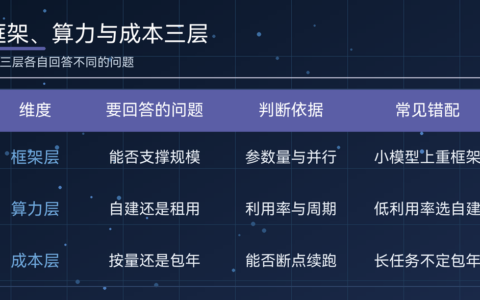
判断当前任务该不该开”深度档”,关键看三件事:任务是否需要多步规划、是否能容忍更长延迟、是否对单次回答准确率敏感。这套判据在 SWE-bench Verified 这类真实工程任务里被反复验证——需要跨多文件改动的 bug 修复,深度档收益最大;只要写一个 helper 函数,普通档就够用。
二、在 AI 编程场景里怎么用
把思考模式接到代码助手,要的不是开关一刀切,而是按”任务复杂度梯度”动态分配。
- 任务分级:把用户请求按”是否跨文件 / 是否需要规划 / 是否需要外部知识”分成三档。简单档走普通推理,中档开低预算 thinking,深档给到最大 budget_tokens。
- 档位参数化:在系统提示里允许通过 API 参数动态调节,例如 OpenAI 的
thinking_effort(low/medium/high)、Anthropic 的thinking={"type": "enabled", "budget_tokens": N}。把档位选择逻辑放进路由层,不让业务代码感知。 - 观察推理痕迹:Claude Extended Thinking 会返回独立的
thinkingcontent 块,可以解析后写入调试日志或评估管线,用于复盘”模型为什么改不动这段代码”。 - 结果重排与缓存:对同一类问题(如固定模板的代码生成),用缓存前缀降低重复思考开销;对低置信度答案触发二次思考或换模型投票。
- 限制过度思考:明确给出最大步数、超时与成本上限,避免模型在简单 bug 上纠结几千个 token 后还改不出 diff。
落到 IDE 插件里的一个常见做法:先用轻量分类器(或一个小模型)判断”是不是复杂任务”,再把请求转发到对应档位。这种”前置路由 + 推理档位”的组合,比无脑调高 thinking 预算更稳妥。
三、典型应用与可参考代码
AI 编程里最容易吃到思考红利的是这几类:多文件重构、依赖升级引发的连锁改动、模糊需求到代码实现的方案设计。下面这段用 Anthropic SDK 调用 Extended Thinking 的代码,能直接套到内部 agent:
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-sonnet-4-5",
    max_tokens=8000,
    thinking={
        "type": "enabled",
        "budget_tokens": 4000,  # 控制"思考"档位的预算
    },
    messages=[
        {
            "role": "user",
            "content": "把 Django 项目里 8 个 view 的重复校验逻辑抽到 mixin,保持现有测试 100% 通过。",
        }
    ],
)

# 思考与最终答案是两个独立的 content 块,要按 list 遍历
for block in response.content:
    if block.type == "thinking":
        log_internal_reasoning(block.thinking)
    elif block.type == "text":
return block.text注意三件事:budget_tokens 是”思考预算”不是输出上限;模型在思考预算内可能选择不用满;超长任务要同步把 max_tokens 调高,否则容易在生成最终 diff 时被截断。
在 OpenAI 这一侧,o1 / o3 系列走的是 reasoning_effort 参数,调高能换来更稳的复杂任务表现,但响应时间和 token 消耗都会明显上升。OpenAI 暂未把内部思考过程暴露给 API(只能拿到最终 answer),这与 Claude Extended Thinking 形成鲜明对比——前者要靠外部评估推断推理质量,后者可以直接观察。
四、容易踩的三个坑
把思考档当成”调高就更准”的银弹,是最常见的误解。模型在简单任务上过度思考时,会出现”自我怀疑—反复回滚—最终仍然选第一个答案”的浪费。判断上限要从具体任务来:SWE-bench 上 7B 模型几乎打不动,再大的 budget 也救不回来;70B+ 模型在多文件改动上才显出优势。
第二个坑是忽视 token 预算:思考档会消耗大量内部 token,表面上”输出更短”,实际账单可能翻倍。建议在路由层同步加一道”成本闸门”——超过单次预算就直接降档或切模型。
第三个坑是把思考过程当聊天直接回显。OpenAI o 系列隐藏内部 CoT 是有意为之,原样暴露反而会泄露训练数据、给用户增加阅读负担。如果真要展示,挑关键判断节点即可,不要全量回放。
到这里,按任务分级、档位参数化、结果回收的链路就基本完整了。是否启用深度档不是信仰问题,而是用任务复杂度、延迟容忍度和成本预算三个变量做权衡。
常见问题(FAQ)
Q1:深度思考和自适应思考是一回事吗?
不是。前者是”内部做大量推理后再答”,后者是”同一模型提供多档推理预算,按需切换”。
Q2:AI 编程助手应该默认开哪一档?
默认普通档,复杂任务(跨文件重构、依赖升级)才升级到深度档,并设置单次预算上限。
Q3:思考过程能直接展示给用户吗?
不建议全量回显。Claude Extended Thinking 可取关键判断节点摘要展示,OpenAI o 系列则默认隐藏。