
网站升级后打不开,绝大多数情况不是服务器真的挂了,而是请求在某一层被”旧状态”拦住了。本地缓存、DNS 缓存、CDN 边缘节点、维护模式这四处,占了升级期间访问异常的绝大多数。真正需要改代码的故障反而少见。按从近到远的顺序逐层排除,通常几分钟就能定位到具体是哪一环。
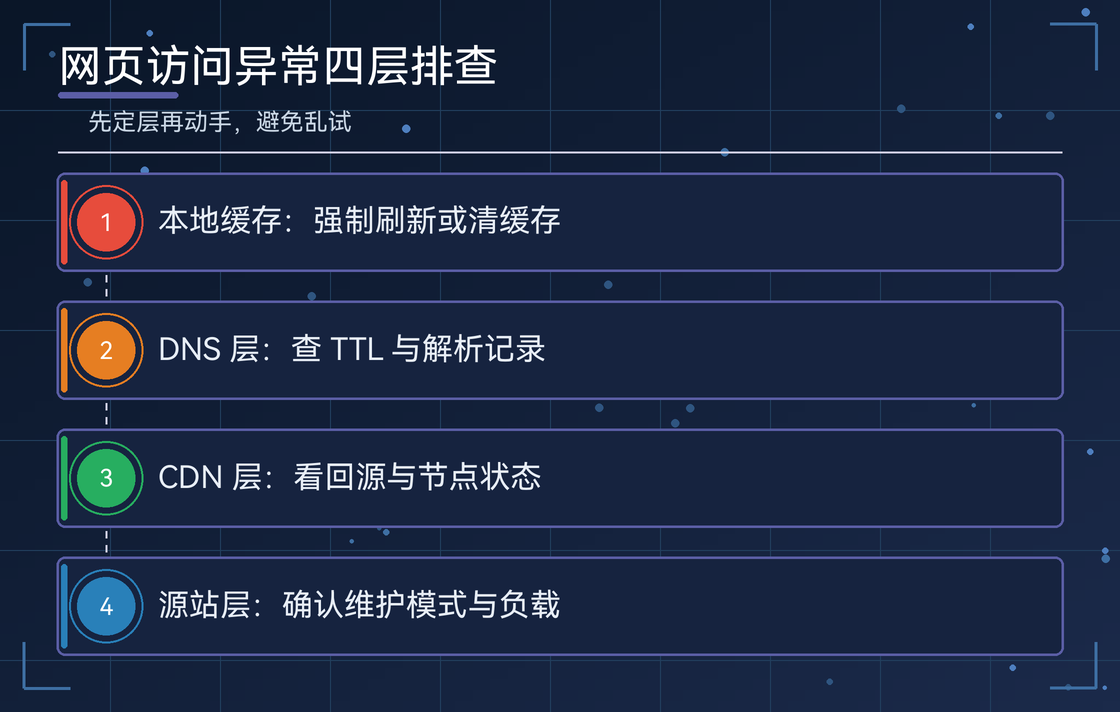
第一步:先看清错误是谁返回的
升级期间遇到的报错,第一件事不是刷新页面,而是确认这个响应来自哪一层。响应头里的 Server 字段和状态码会直接告诉你答案:CDN 返回的和源站返回的,处理路径完全不同。用一条命令就能看到,浏览器开发者工具的 Network 面板同样能看到这两项。
# 只看响应头:状态码、Server、Cache-Control、Retry-After
curl -sI https://www.example.com

# 绕过本机解析,直接指定 IP 访问源站(对比 CDN 与源站差异)
curl -sI https://www.example.com --resolve www.example.com:443:203.0.113.10
状态码的含义值得先对齐,很多人把 502、503、504 混为一谈:
| 状态码 | 含义 | 升级期间的典型来源 |
|---|---|---|
| 502 | 网关收到上游无效响应 | 反向代理连不上刚重启的应用进程 |
| 503 | 服务暂时不可用 | 维护模式、进程池耗尽、CDN 找不到健康源站 |
| 504 | 上游超时未响应 | 升级脚本卡住、数据库迁移耗时过长 |
| 200 但页面是旧的 | 命中缓存 | 浏览器、CDN 或中间代理缓存未刷新 |
区分开这几种,后面每一类坑的排查范围就能立刻收窄。
坑一:本地缓存还在给你看旧页面
浏览器自身的 DNS 缓存和页面缓存独立于操作系统,清了系统缓存也可能无效。判断是否属于这一类,省事的做法是开一个无痕窗口,或者换一个浏览器访问:无痕窗口正常而常规窗口异常,就是本地缓存在作怪。
处理顺序建议按从轻到重来:
- 开无痕窗口或换浏览器访问,排除浏览器缓存;
- 强制刷新(Windows 与 Linux 上按 Ctrl + F5,macOS 上按 Cmd + Shift + R);
- 清理操作系统 DNS 缓存,Windows 执行
ipconfig /flushdns,macOS 执行sudo killall -HUP mDNSResponder,Linux 执行sudo systemd-resolve --flush-caches; - 换一个网络(比如手机热点)访问,排除运营商递归 DNS 的缓存。
做完这四步还是老样子,问题就在服务端了,继续往下看。
坑二:DNS 记录还没过期
改了解析记录却迟迟不生效,根因几乎都在 TTL(Time To Live)上。权威 DNS 服务器上的修改是即时生效的,但全球各级递归 DNS 会按原 TTL 缓存旧记录,缓存不到期就不会重新查询。所以切换 IP 后用户访问异常,先查权威再查公共 DNS,两边结果不一致就说明缓存还在陆续过期。
# 查权威 NS,看到的是配置的真实值
dig @ns1.example-dns.com www.example.com A +short

# 同时问几家公共 DNS,结果不一致即为缓存未同步
dig @8.8.8.8 www.example.com A +short
dig @1.1.1.1 www.example.com A +short
常见的 TTL 取值与大致等待时间如下:
| TTL 设置 | 缓存时长 | 全球大致生效时间 |
|---|---|---|
| 300 秒 | 5 分钟 | 几分钟到十几分钟 |
| 3600 秒 | 1 小时 | 一到两小时 |
| 86400 秒 | 24 小时 | 最长可接近一天 |
正确做法是提前规划:计划升级前一两天把 TTL 调到 300 秒,等旧 TTL 全部过期后再切换,切换完成并观察稳定后再把 TTL 调回去。临时抱佛脚直接改解析,就只能等旧 TTL 慢慢耗尽,期间反复改记录只会把情况弄得更乱。
坑三:CDN 边缘节点缓存了旧版本或错误页
CDN 是升级期间最容易背锅也最容易被忽略的一层。它可能在两种情况下出问题:一是缓存了升级前的静态资源,用户拿到的是混合了新旧版本的页面,表现为样式错乱、按钮点了没反应;二是源站健康检查失败,CDN 找不到可用后端,直接返回自己的 503 页面——这时源站可能已经恢复正常,但边缘节点还在报错。
判断方法是用上面那条 --resolve 命令直接打源站:源站返回 200 而域名访问返回 503,问题就在 CDN 或代理层。处理手段有三类:在 CDN 控制台按目录或 URL 做刷新(purge),对静态资源使用带版本号的文件名或加查询串,以及确认源站健康检查路径在升级期间也能正常返回。
还有个细节容易被忽略:维护期间返回的 503 页面如果带了较长的 Cache-Control,会被边缘节点缓存下来,源站修好了用户依然看到错误页。给 503 响应设置不缓存,并加上 Retry-After 头告知重试时间,能避免这个问题。
坑四:维护模式没退出来
这一类的共同特征是”所有人都打不开,且页面样式统一”。常见触发场景有三个:部署脚本中断,维护标记文件没被清理;进程池参数在升级后没有同步调整,请求全部排队;数据库迁移未完成,应用层主动拒绝服务。
以 WordPress 为例,更新过程被中断会在站点根目录留下 .maintenance 文件,删除它通常就能恢复。容器化部署则要看进程是否处于反复重启的崩溃循环,以及新版本的配置在新环境下是否完整。这一类问题的排查重点在应用日志和进程状态,而不是网络。
一条可复制的排查顺序
把上面四类坑串起来,升级后访问异常的排查可以按固定顺序走,避免东一榔头西一棒子:
- 用
curl -sI拿状态码与 Server 字段,判断响应来自 CDN 还是源站; - 开无痕窗口或换浏览器,排除本地缓存;
- 对比权威 NS 与多家公共 DNS 的解析结果,确认 DNS 是否已同步;
- 用
--resolve直连源站,区分是边缘节点问题还是源站问题; - 在 CDN 控制台刷新对应目录或 URL,并检查健康检查配置;
- 查应用日志与进程状态,确认维护模式已退出、迁移已完成。
顺序的意义在于成本递增:前两步零成本,中间两步需要控制台权限,最后一步要登录服务器。大多数升级期的访问异常,走完前三步就有结论了。
常见问题(FAQ)
Q1:升级后部分用户正常、部分打不开,为什么?
多为 DNS 缓存或 CDN 节点未同步,各地递归 DNS 缓存过期时间不同,等待 TTL 耗尽即可。
Q2:503 页面会不会影响搜索排名?
短时间 503 通常影响有限,搜索引擎能理解其为临时状态;长时间未恢复则可能被误判为站点不稳定。
Q3:改完 DNS 记录多久能生效?
取决于旧 TTL 值,300 秒约几分钟,86400 秒最长接近一天,权威服务器上的修改本身是即时的。

