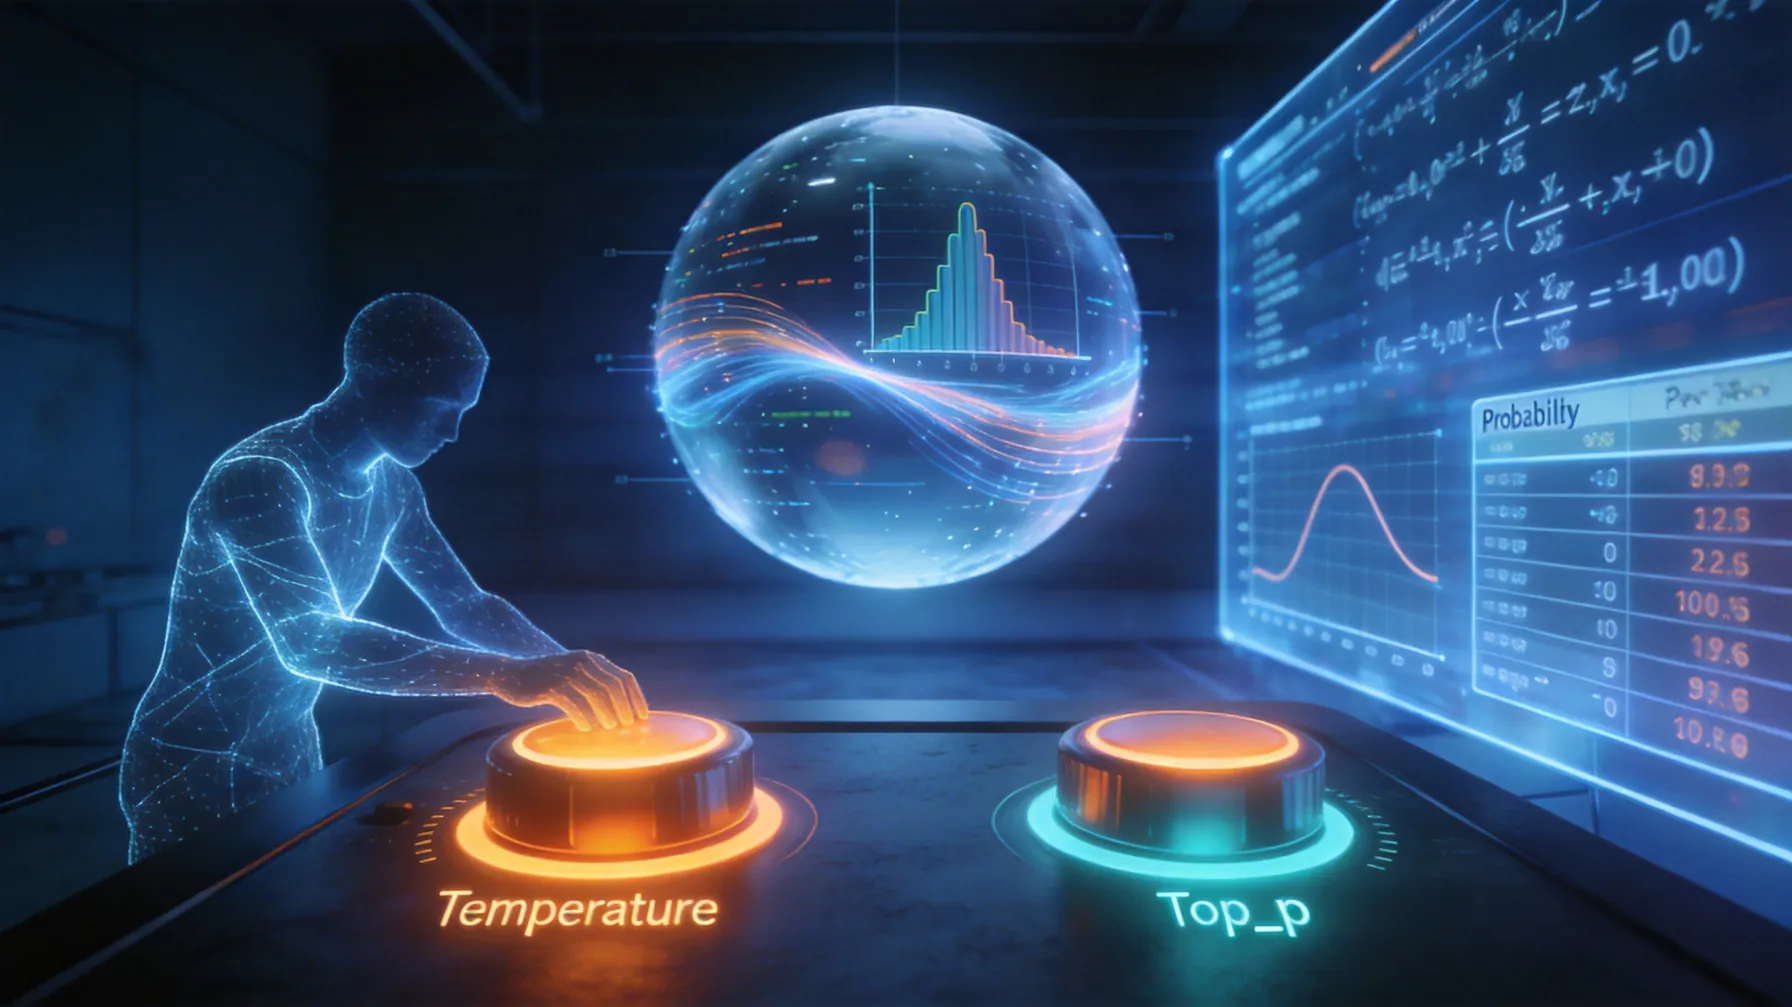
在调用大语言模型(LLM)API 时,temperature 和 top_p(也称 nucleus sampling)是两个最关键的文本生成控制参数,它们共同决定了模型输出的随机性、多样性与确定性。合理调整这两个参数,能显著影响 AI 回答的创意性、稳定性与可靠性。理解其工作原理并掌握调参策略,是构建高质量 AI 应用的基础。
一、核心概念解析
1. Temperature(温度)
- 作用:控制模型对 token 概率分布的“平滑”程度。
- 取值范围:通常为 0.0 ~ 2.0(部分平台上限为 1.0 或 5.0)。
- 工作原理:
- 低 temperature(如 0.1):放大高概率 token 的优势,抑制低概率选项 → 输出更确定、保守、重复性高;
- 高 temperature(如 1.0+):使概率分布更均匀 → 输出更随机、多样、富有创意,但也更易出错或不连贯。
🔍 类比:低温像“死记硬背的学生”,高温像“天马行空的诗人”。
2. Top-p(Nucleus Sampling)
- 作用:动态截断概率分布,仅从累积概率达到 p 的最小 token 集合中采样。
- 取值范围:0.0 ~ 1.0。
- 工作原理:
- 低 top_p(如 0.5):只考虑最可能的少数几个 token → 输出更聚焦、安全;
- 高 top_p(如 0.95):包含更多低概率 token → 输出更丰富、不可预测。
💡 关键区别:temperature 改变整个分布形状,top_p 动态选择采样池大小。
二、参数组合效果对比
| 参数组合 | 输出特性 | 典型应用场景 |
|---|---|---|
| temp=0.1, top_p=0.5 | 极度确定,几乎每次相同 | 代码生成、事实问答、结构化数据提取 |
| temp=0.7, top_p=0.9 | 平衡创意与可控性 | 内容创作、营销文案、对话机器人 |
| temp=1.2, top_p=0.95 | 高度随机,充满惊喜 | 诗歌、故事、头脑风暴 |
| temp=0.0(或接近) | 完全确定性(贪心解码) | 数学推理、法律条款引用 |
⚠️ 注意:temperature=0 并非所有平台都支持,部分系统会自动设为极小值(如 0.01)以避免除零错误。
三、如何选择合适的值?
✅ 原则 1:根据任务类型决定
| 任务类型 | 推荐 temperature | 推荐 top_p | 理由 |
|---|---|---|---|
| 事实性问答 | 0.1 ~ 0.3 | 0.5 ~ 0.8 | 最小化幻觉,确保答案准确 |
| 代码生成 | 0.2 ~ 0.5 | 0.7 ~ 0.9 | 兼顾语法正确性与实现多样性 |
| 创意写作 | 0.7 ~ 1.0 | 0.8 ~ 0.95 | 激发新颖表达,避免陈词滥调 |
| 多轮对话 | 0.5 ~ 0.8 | 0.8 ~ 0.9 | 保持自然流畅,避免机械重复 |
| 推理/CoT | 0.3 ~ 0.6 | 0.7 ~ 0.9 | 允许适度探索,但保证逻辑连贯 |
✅ 原则 2:避免极端组合
- ❌
temp=2.0 + top_p=0.99:输出可能语无伦次、逻辑断裂; - ❌
temp=0.01 + top_p=0.1:过度僵化,无法处理同义表达。
✅ 原则 3:优先调 temperature,再微调 top_p
- temperature 主导整体风格;
- top_p 用于精细控制尾部噪声。
四、高级使用技巧
1. 动态参数调整
根据用户意图实时切换:
- 用户问“Python 如何读取文件?” →
temp=0.2 - 用户说“写一首关于春天的诗” →
temp=0.9
2. 结合 Self-Consistency 使用高 temperature
在自洽性(Self-Consistency)框架中,故意设置较高 temperature(如 0.7~1.0),以生成多样化的推理路径,再通过投票选出最一致答案。
3. 安全兜底:关键任务强制低 temperature
对医疗、金融、法律等高风险场景,全局锁定 temp ≤ 0.3,即使牺牲部分流畅性,也要保障事实准确性。
五、各平台默认值参考
| 平台/模型 | 默认 temperature | 默认 top_p | 备注 |
|---|---|---|---|
| OpenAI GPT-4 | 1.0 | 1.0 | 高创意默认 |
| Anthropic Claude | 1.0 | 0.99 | 类似 GPT |
| Google Gemini | 0.9 | 0.95 | 平衡型 |
| Llama 2 / 3 | 0.6 ~ 0.8 | 0.9 | 开源常用默认 |
| Qwen(通义千问) | 0.8 | 0.9 | 中文优化 |
📌 建议:不要依赖默认值!根据业务需求显式设置参数。
六、实验建议:A/B 测试调优
- 固定其他变量,仅调整 temperature(如 0.2 / 0.5 / 0.8);
- 收集 50~100 条真实用户 query,人工评估:
- 准确性
- 流畅度
- 多样性
- 安全性
- 选择综合得分最高的组合。
工具推荐:使用 LangSmith、Weights & Biases 等平台记录和对比不同参数下的输出质量。
总结
- Temperature 控制“胆量”:低则谨慎,高则大胆;
- Top-p 控制“视野”:低则聚焦,高则开放;
- 事实任务 → 低温低 p;创意任务 → 高温高 p;
- 永远不要盲目使用默认值,而应基于任务目标主动调参。
掌握这两个参数,你就拥有了“调节 AI 性格”的旋钮——让它在严谨专家与创意伙伴之间自由切换,真正服务于你的业务场景。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 qiqicto@qq.com 举报,一经查实,本站将立刻删除。