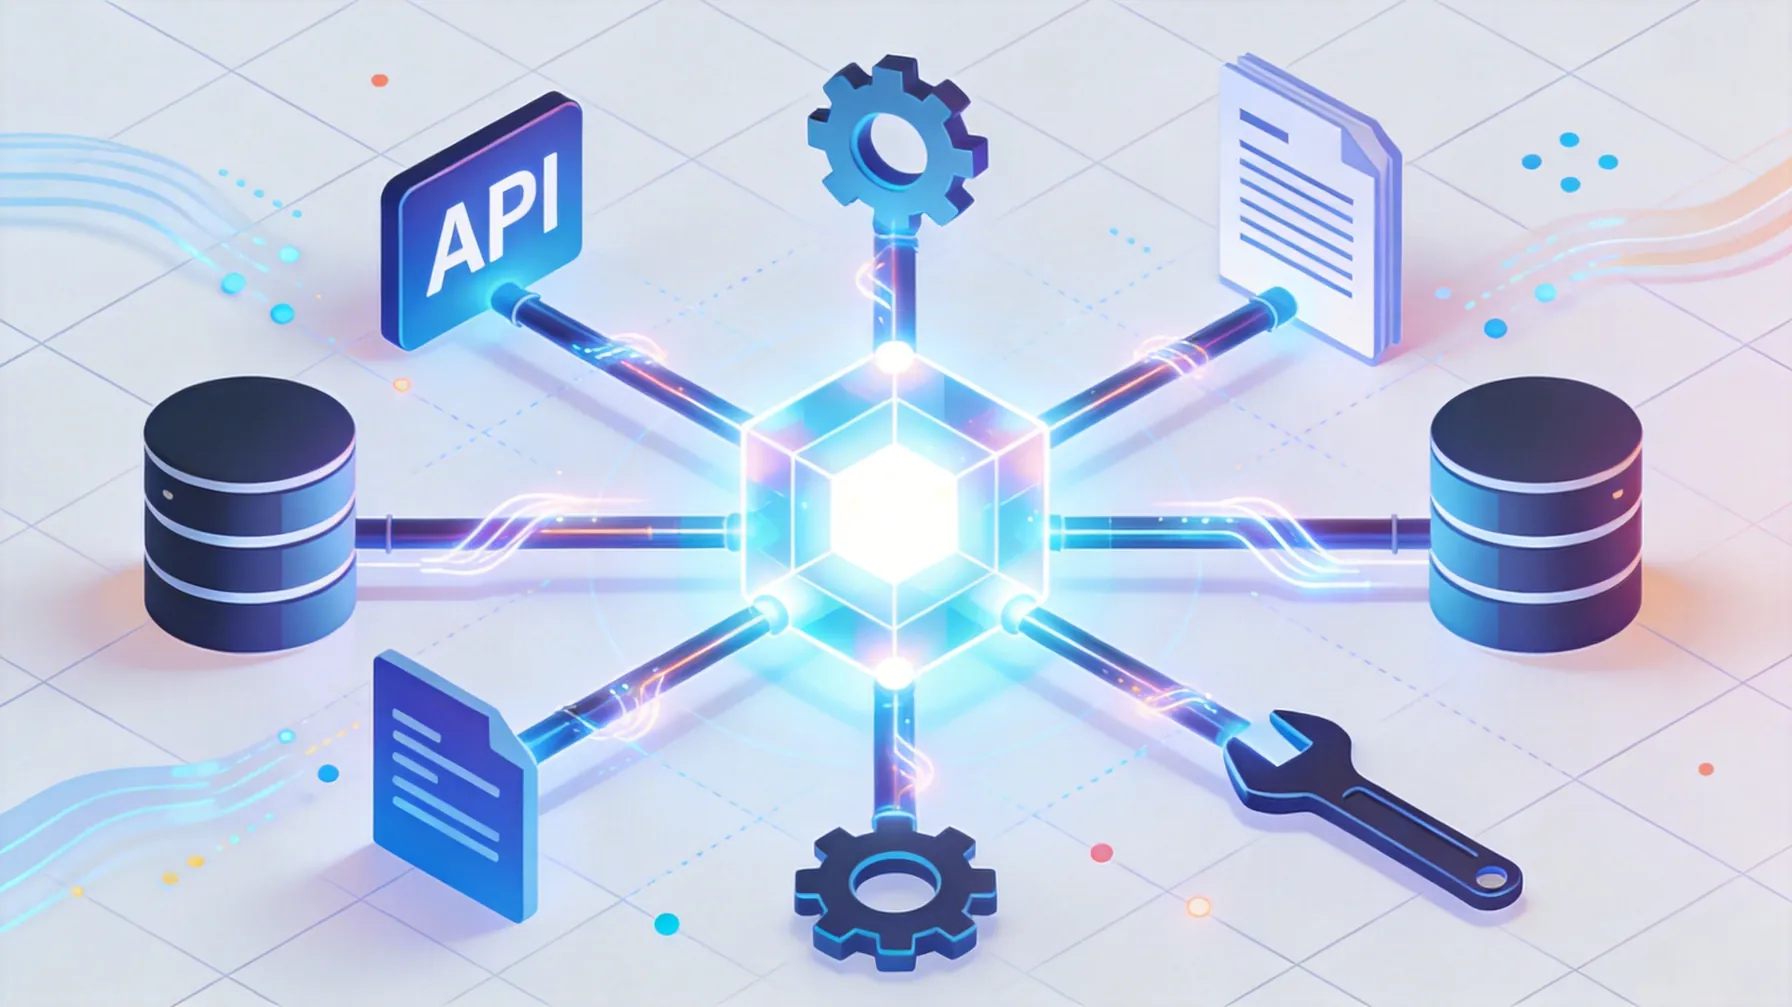
LangChain 是一个开源的、模块化的 大语言模型(LLM)应用开发框架,旨在简化开发者将 LLM 与外部数据、工具、逻辑和记忆系统集成的过程。它不是另一个大模型,而是一个“胶水层”——帮助你把 LLM、数据库、API、向量存储、业务逻辑等组件无缝拼接成强大的 AI 应用。
✅ 简单说:LangChain = LLM + 外部世界 + 应用逻辑 的连接器
一、LangChain 诞生的背景:为什么需要它?
早期使用 LLM(如 GPT-4)时,开发者面临三大痛点:
| 痛点 | 说明 |
|---|---|
| 1. 上下文长度限制 | 无法直接处理长文档、全量知识库 |
| 2. 知识静态且过时 | 模型训练截止后,无法获取新信息 |
| 3. 缺乏行动能力 | 只能“说”,不能“做”(如查数据库、发邮件) |
LangChain 通过提供标准化组件和模式,系统性解决这些问题。
二、LangChain 的核心设计理念
LangChain 围绕 六个关键抽象 构建:
1. Models(模型)
- 支持主流 LLM(OpenAI, Anthropic, Llama, Qwen 等)和 Embedding 模型;
- 统一接口,轻松切换模型供应商。
2. Prompts(提示词)
- 提供
PromptTemplate、FewShotPromptTemplate等工具; - 支持动态变量注入、示例选择、输出解析。
3. Chains(链)
- 将多个步骤串联成工作流(如:检索 → 生成 → 格式化);
- 内置常用链:
RetrievalQA、ConversationalRetrievalChain、SQLDatabaseChain。
4. Agents(智能体)
- 让 LLM 自主调用工具(如搜索、计算器、自定义 API);
- 支持 ReAct、Plan-and-Execute 等推理策略。
5. Memory(记忆)
- 在对话中持久化上下文(如短期聊天历史、长期用户画像);
- 支持
ConversationBufferMemory、VectorStoreRetrieverMemory等。
6. Indexes & Retrievers(索引与检索器)
- 将文档切分、嵌入、存入向量数据库(如 Chroma, Pinecone);
- 实现 RAG(检索增强生成),突破上下文限制。
🔗 这些组件可像乐高一样自由组合,构建复杂应用。
三、LangChain 主要解决的问题
问题 1:如何让 LLM 使用私有或实时数据?
- 方案:RAG(检索增强生成)
- LangChain 实现:
from langchain_community.vectorstores import Chroma
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain.chains import RetrievalQA

vectorstore = Chroma.from_documents(docs, OpenAIEmbeddings())
retriever = vectorstore.as_retriever()
qa_chain = RetrievalQA.from_chain_type(
    llm=ChatOpenAI(),
    retriever=retriever,
    chain_type="stuff"
)
result = qa_chain.invoke("公司最新的请假政策是什么?")
问题 2:如何让 LLM 执行多步任务?
- 方案:Chains(链式调用)
- 示例:先总结文档,再翻译,最后发邮件
summary_chain | translate_chain | email_chain
问题 3:如何让 LLM 与外部工具交互?
- 方案:Agents(智能体)
- 示例:让 AI 自动查天气并建议穿衣
from langchain.agents import load_tools, initialize_agent

tools = load_tools(["serpapi", "llm-math"], llm=llm)
agent = initialize_agent(tools, llm, agent="zero-shot-react-description")
agent.run("今天北京天气如何?我该穿什么?")
问题 4:如何在对话中记住用户信息?
- 方案:Memory(记忆)
- 示例:客服机器人记住用户订单号
memory = ConversationBufferMemory(memory_key="chat_history")
chain = LLMChain(llm=llm, prompt=prompt, memory=memory)
四、典型应用场景
| 场景 | LangChain 组件组合 |
|---|---|
| 企业知识库问答 | Document Loaders → Text Splitters → VectorStore → RetrievalQA |
| 智能客服 | Memory + Prompt Templates + Agent(调用工单系统) |
| 自动化报告生成 | SQLDatabaseChain + LLMChain(分析+撰写) |
| AI 编程助手 | Code Interpreter Tool + ReAct Agent |
| 个性化推荐引擎 | User Profile Memory + RAG + Custom Scoring Chain |
五、LangChain 的生态优势
1. 丰富的集成
- 支持 100+ 工具、50+ 向量数据库、30+ LLM 提供商;
- 开箱即用:Slack、Google Calendar、Wikipedia、Zapier 等。
2. LCEL(LangChain Expression Language)
- 声明式语法构建复杂链:
chain = prompt | llm | StrOutputParser() - 支持异步、流式输出、并行执行。
3. 生产就绪特性
- 内置重试、缓存、日志、监控;
- 与 LangSmith(调试/测试平台)深度集成。
4. 社区与文档
- GitHub 超 70k stars,活跃社区;
- 官方文档详尽,含大量教程和模板。
六、适用人群与学习路径
| 角色 | 如何使用 LangChain |
|---|---|
| 开发者 | 快速构建 MVP,避免重复造轮子 |
| 数据科学家 | 将 LLM 集成到数据分析 pipeline |
| 产品经理 | 利用模板快速验证 AI 功能可行性 |
| 研究人员 | 实验新型 Agent 架构或 RAG 策略 |
📚 学习建议:
- 掌握基本组件(Model, Prompt, Chain)
- 实践 RAG 应用
- 尝试构建简单 Agent
- 使用 LangSmith 调试优化
七、局限性与注意事项
| 局限 | 应对建议 |
|---|---|
| 抽象带来性能开销 | 关键路径可手写优化 |
| 版本迭代快 | 锁定依赖,关注 changelog |
| 复杂 Agent 不稳定 | 加入人工审核节点,设置最大步数 |
| Token 成本不可控 | 监控输入长度,压缩 Prompt |
总结
LangChain 的核心价值在于:将 LLM 从“孤立的语言模型”转变为“可连接、可扩展、可落地的智能系统”。它解决了 LLM 应用开发中的三大鸿沟:
- 数据鸿沟 → 通过 RAG 接入私有知识
- 能力鸿沟 → 通过 Agents 调用工具
- 逻辑鸿沟 → 通过 Chains 编排流程
无论你是想快速搭建一个文档问答机器人,还是构建复杂的多 Agent 协作系统,LangChain 都提供了经过验证的模式和工具,大幅降低开发门槛。
一句话定位:
LangChain 不是让你“拥有 AI”,而是让你“驾驭 AI”。
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 qiqicto@qq.com 举报,一经查实,本站将立刻删除。